


Redis总结
基础与结构
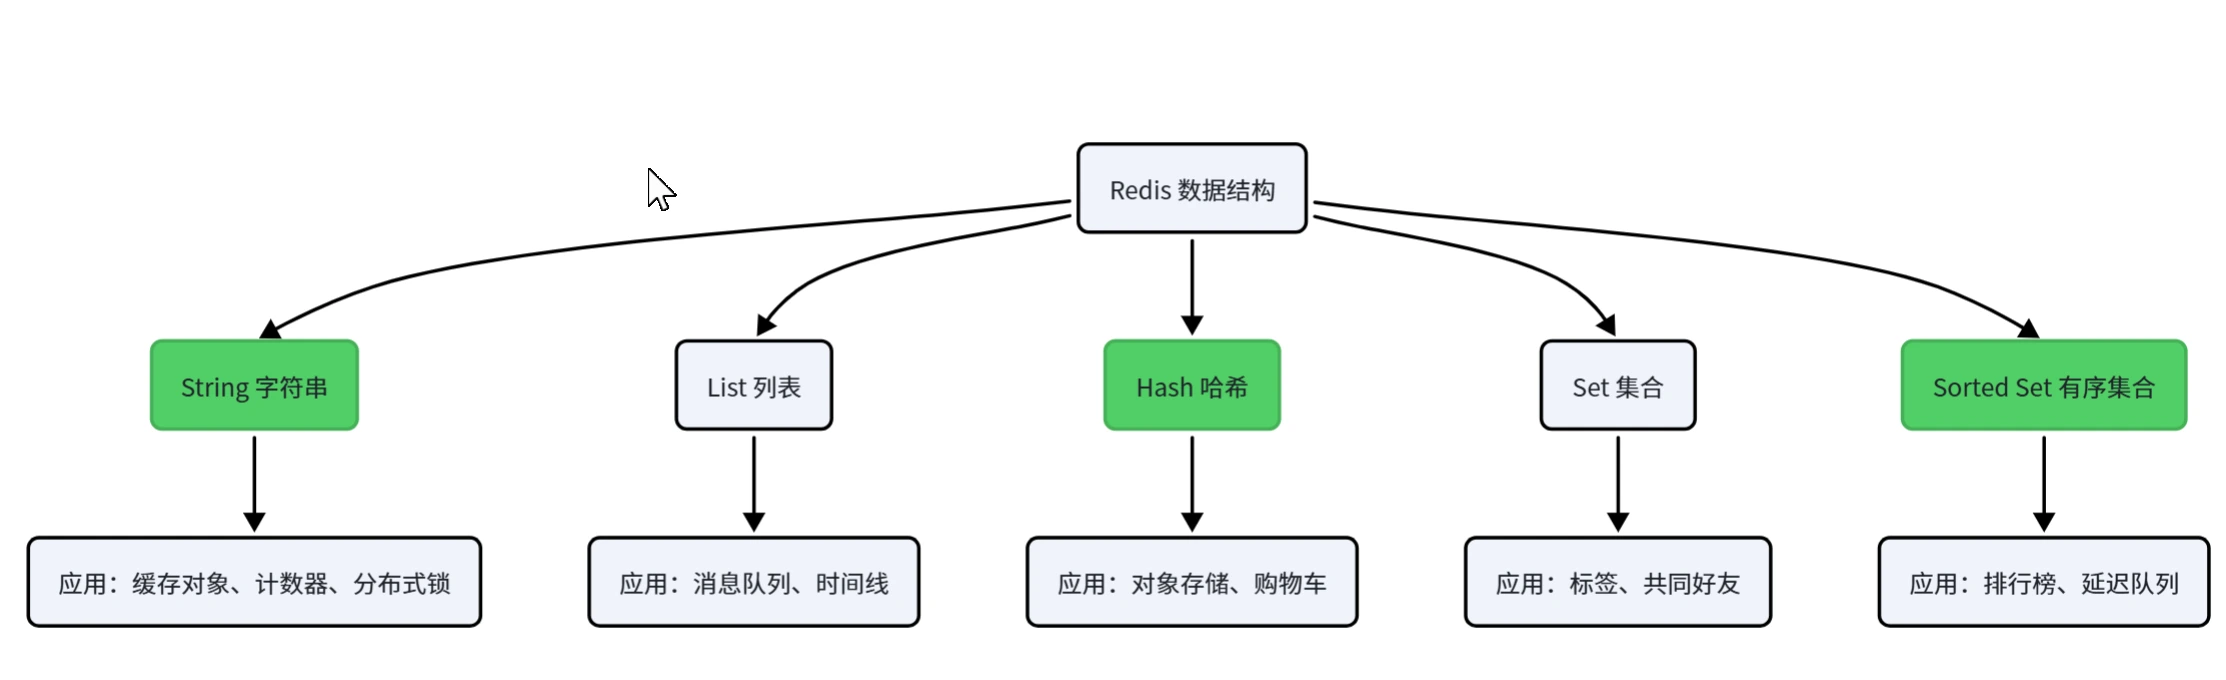
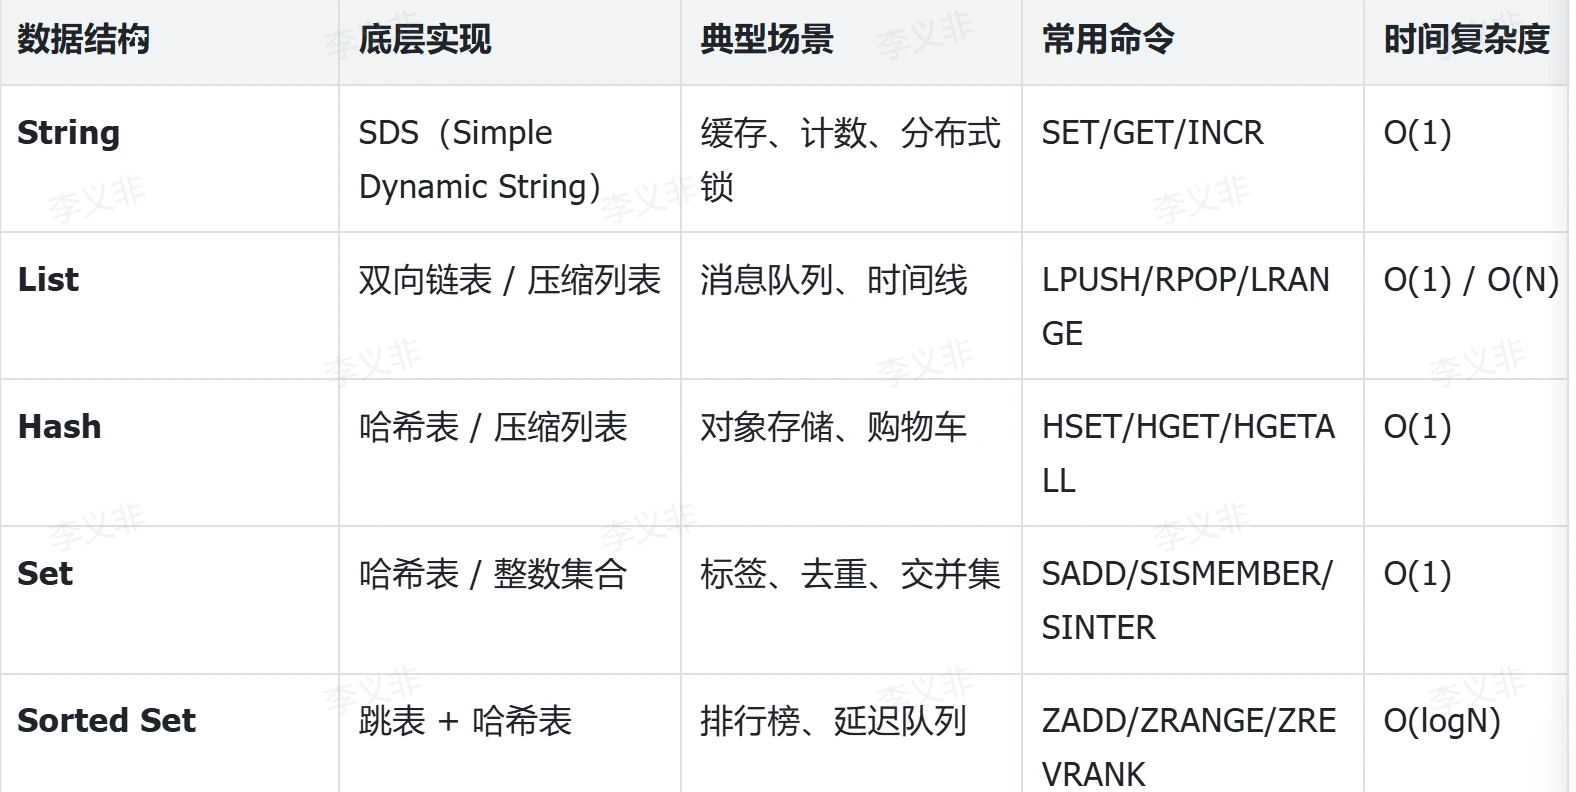
Redis中存储的数据都是以key.value对的形式存储,而value的形式多种多样,可以是字符串.数值.甚至json
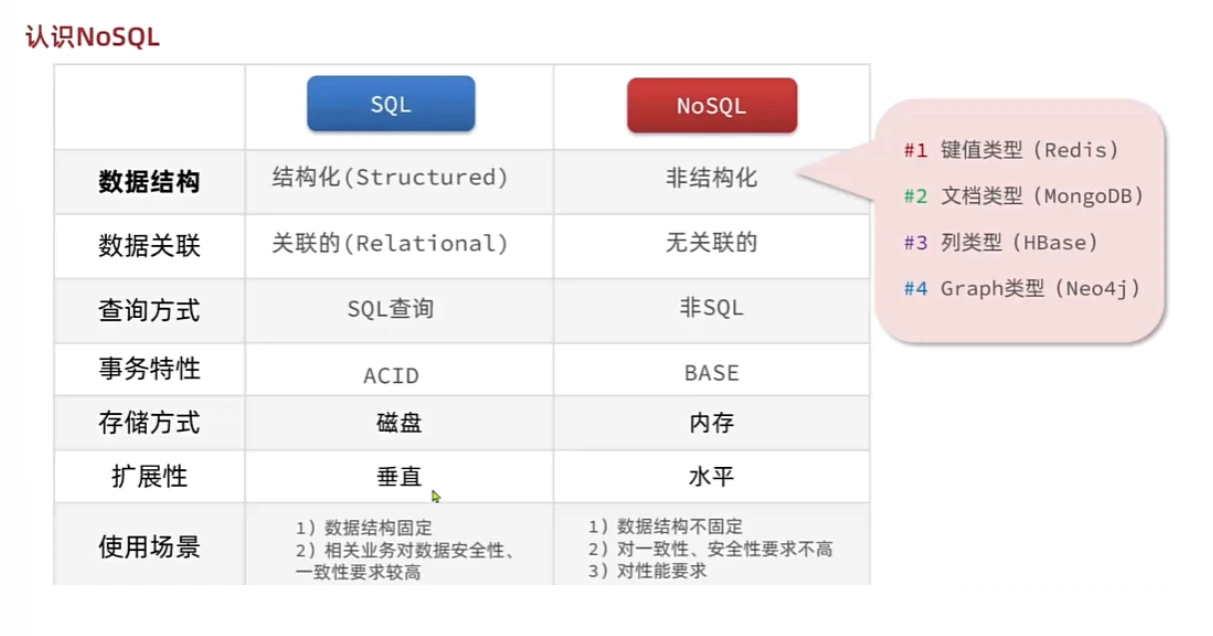
NoSql为非关系型数据库。
- 缓存:减轻数据库压力
- 分布式锁:解决并发问题
- 消息队列:发布订阅,Stream
- 计数器:UV/PV统计
- 排行榜:Sorted Set
核心特性:
- 单线程模型(Redis6.0之后引入了多线程IO)
- 基于内存读写快(10w+QPS)
- 支持持久化(RDB,AOF)
- 支持主从复制,哨兵,集群
命令
通用
KEYS:查看符合模板的所有keykeys *; keys a* 模糊查询,单线程可能会堵塞数据量大时
DEL:删除一个指定的key
EXISTS:判断key是否存在
EXPIRE:给一个key设置有效期,有效期到期时该key会被自动删除
TTL:查看一个KEY的剩余有效期
如果该值未设置有效期,则直接返回-1
如果该值设置有效期,未失效时返回剩余有效期,失效后则返回-2String
SET:添加或者修改已经存在的一个String类型的键值对 如果key不存在则是新增,如果存在则是修改
GET:根据key获取String类型的value
MSET:批量添加多个String类型的键值对
MGET:根据多个key获取多个String类型的value
INCR:让一个整型的key自增1
INCRBY:让一个整型的key自增并指定步长,例如:incrby num 2 让num值自增2
SET NX:添加一个String类型的键值对,前提是这个key不存在,否则不执行set name yifei nx
SET EX:添加一个String类型的键值对,并且指定有效期set name liyifei ex 10
APPEND key value // 将指定的value追加到该key原来值value的末尾层级结构
Redis没有类似MySQL中的Table的概念,我们该如何区分不同类型的key呢?
我们的项目名称叫 heima,有user和product两种不同类型的数据,我们可以这样定义key:
- :user相关的key:heima:user<1>
- product相关的key:heima:product<1>
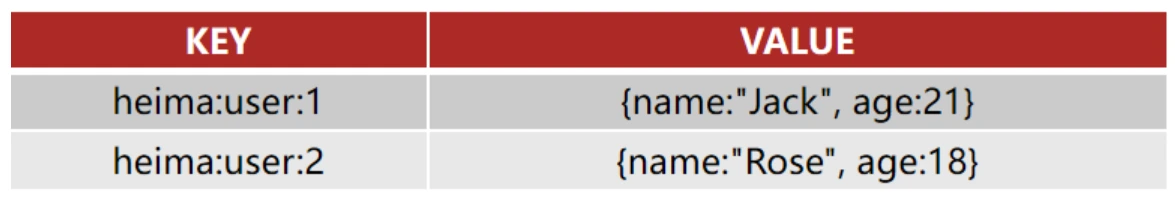
如果Value是一个Java对象,例如一个User对象,则可以将对象序列化为JSON字符串后存储:
**KEY VALUE**
**heima:user:1 {"id":1, "name": "Jack", "age": 21}**
**heima:product:1 {"id":1, "name": "小米11", "price": 4999}Hash
- Hash类型,也叫散列,其value是一个无序字典,类似于Java中的HashMap结构。
- String结构是将对象序列化为JSON字符串后存储,当需要修改对象某个字段时很不方便
Hash结构可以将对象中的每个字段独立存储,可以针对单个字段做CRUD
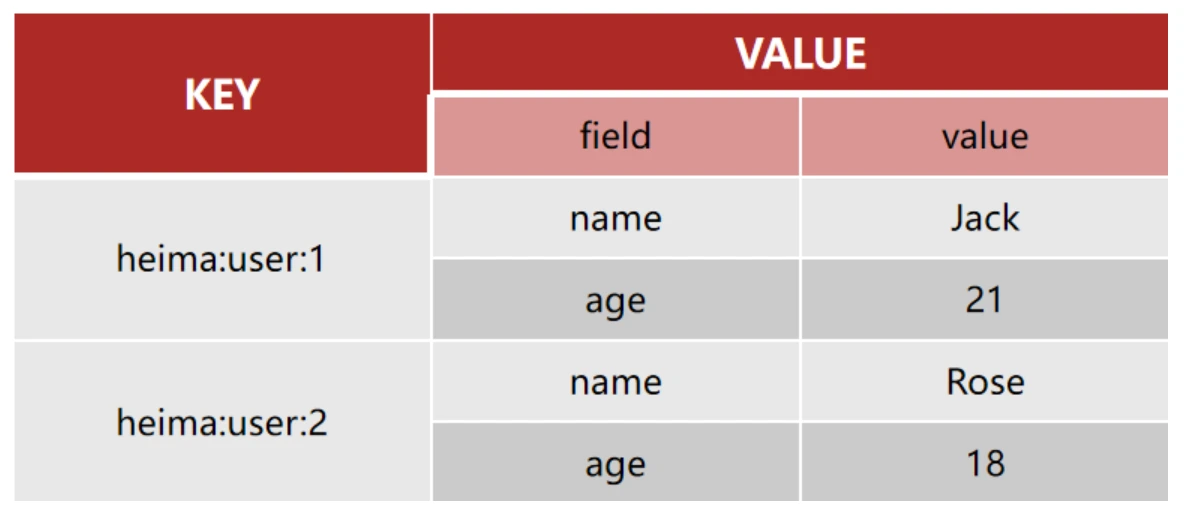
HSET key field value:添加或者修改hash类型key的field的值HSET heima:user:3 name Lucy
HGET key field:获取一个hash类型key的field的值HGET heima:user:3 name
HMSET:批量添加多个hash类型key的field的值HMSET heima:user:3 name LiLei age 20
HMGET:批量获取多个hash类型key的field的值HMGET heima:user:3 name age
HGETALL:获取一个hash类型的key中的所有的field和value
HKEYS:获取一个hash类型的key中的所有的field
HINCRBY:让一个hash类型key的字段值自增并指定步长
HSETNX:添加一个hash类型的key的field值,前提是这个field不存在,否则不执行List
Redis中的List类型与Java中的LinkedList类似,可以看做是一个双向链表结构。既可以支持正向检索和也可以支持反向检索。
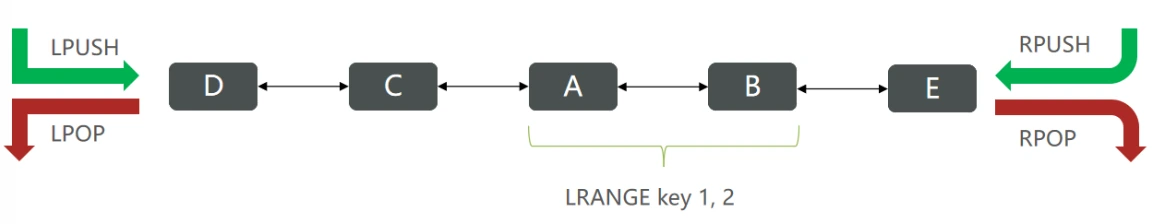
- 有序
- 元素可以重复
- 插入和删除快
- 查询速度一般
LPUSH key element :向列表左侧插入一个或多个元素
LPOP key:移除并返回列表左侧的第一个元素,没有则返回nil
RPUSH key element :向列表右侧插入一个或多个元素
RPOP key:移除并返回列表右侧的第一个元素
LRANGE key star end:返回一段角标范围内的所有元素
BLPOP和BRPOP:与LPOP和RPOP类似,只不过在没有元素时等待指定时间,而不是直接返回nilSet
Redis的Set结构与Java中的HashSet类似,可以看做是一个value为null的HashMap。也是一个hash表,因此具备与HashSet类似的特征:
- 无序
- 元素不可重复
- 查找快
- 支持交集.并集.差集等功能
SADD key member :向set中添加一个或多个元素
SREM key member : 移除set中的指定元素
SCARD key: 返回set中元素的个数
SISMEMBER key member:判断一个元素是否存在于set中
SMEMBERS:获取set中的所有元素
SINTER key1 key2 :求key1与key2的交集
SDIFF key1 key2 :求key1与key2的差集
SUNION key1 key2 :求key1和key2的并集SortedSet
Redis的SortedSet是一个可排序的set集合,与Java中的TreeSet有些类似,但底层数据结构却差别很大。SortedSet中的每一个元素都带有一个score属性(可理解为权值),可以基于score属性对元素排序,底层的实现是一个跳表(SkipList)加 hash表。
- 可排序 实现排行榜这样的功能
- 元素不重复
- 查询速度快
ZADD key score member:添加一或多个元素,如已存在则更新其score值
ZCARD key:获取sorted set中的元素个数
ZREM key member:删除sorted set中的一个指定元素
ZSCORE key member : 获取sorted set中的指定元素的score值
ZRANK key member:获取sorted set 中的指定元素的排名
ZCOUNT key min max:统计score值在给定范围内的所有元素的个数
ZINCRBY key increment member:让sorted set中的指定元素自增,步长为increment
ZRANGE key min max:按照score排序后,获取指定排名范围内的元素
ZRANGEBYSCORE key min max:按照score排序后,获取指定score范围内的元素
ZDIFF.ZINTER.ZUNION:求差集.交集.并集
注意:所有的排名默认都是升序,如果要降序则在命令的Z后面添加REV即可
升序获取sorted set 中的指定元素的排名:ZRANK key member
降序获取sorted set 中的指定元素的排名:ZREVRANK key memebe连接
Jedis
Jedis和Lettuce:这两个主要是提供了Redis命令对应的API,方便我们操作Redis,而SpringDataRedis又对这两种做了抽象和封装,因此我们后期会直接以SpringDataRedis来学习。
Jedis本身是线程不安全的,并且频繁的创建和销毁连接会有性能损耗,因此我们推荐大家使用Jedis连接池代替Jedis的直连方式
<dependency> <groupId>redis.clients</groupId> <artifactId>jedis</artifactId> <version>3.7.0</version></dependency>public class JedisConnectionFacotry { private static final JedisPool jedisPool; static { //配置连接池 JedisPoolConfig poolConfig = new JedisPoolConfig(); poolConfig.setMaxTotal(8); poolConfig.setMaxIdle(8); poolConfig.setMinIdle(0); poolConfig.setMaxWaitMillis(1000); //创建连接池对象 jedisPool = new JedisPool(poolConfig, "192.168.150.101",6379,1000,"123321"); }
public static Jedis getJedis(){ return jedisPool.getResource(); }}-
JedisConnectionFacotry:工厂设计模式是实际开发中非常常用的一种设计模式,我们可以使用工厂,去降低代码的耦合,比如Spring中的Bean的创建,就用到了工厂设计模式
-
静态代码块:随着类的加载而加载,确保只能执行一次,我们在加载当前工厂类的时候,就可以执行static的操作完成对 连接池的初始化
-
最后提供返回连接池中连接的方法
@BeforeEach void setUp(){ //建立连接 /*jedis = new Jedis("127.0.0.1",6379);*/ jedis = JedisConnectionFacotry.getJedis(); //选择库 jedis.select(0); }
@AfterEach void tearDown() { if (jedis != null) { jedis.close(); } }在我们完成了使用工厂设计模式来完成代码编写后,我们在获得连接时,就可通过工厂来获得,而不用直接去new对象,降低耦合,并且使用的还是连接池对象。
当我们使用了连接池后,当我们关闭连接其实并不是关闭,而是将Jedis还回连接池的。
Template
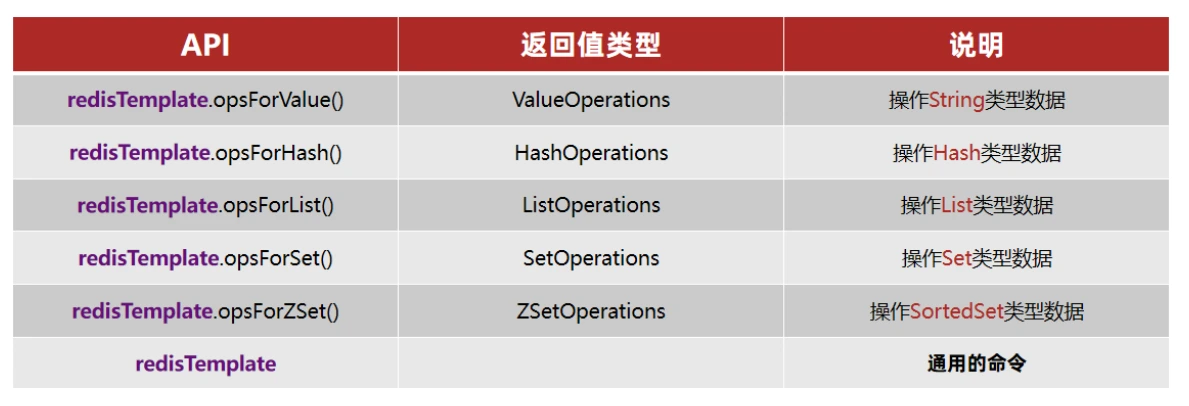
Object序列化为字节形式,默认是采用JDK序列化*可读性差,内存占用较大
//自定义序列化器@Configurationpublic class RedisConfig { @Bean public RedisTemplate<String, Object> redisTemplate(RedisConnectionFactory connectionFactory){ // 创建RedisTemplate对象 RedisTemplate<String, Object> template = new RedisTemplate<>();
// 设置连接工厂 template.setConnectionFactory(connectionFactory);
// 创建JSON序列化工具 GenericJackson2JsonRedisSerializer jsonRedisSerializer = new GenericJackson2JsonRedisSerializer(); // 设置Key的序列化 template.setKeySerializer(RedisSerializer.string()); template.setHashKeySerializer(RedisSerializer.string()); // 设置Value的序列化 template.setValueSerializer(jsonRedisSerializer); template.setHashValueSerializer(jsonRedisSerializer); // 返回 return template; }}自定义RedisTemplate
修改RedisTemplate的序列化器为GenericJackson2JsonRedisSerializer@Autowired private StringRedisTemplate stringRedisTemplate;
@Test void testString() { // 写入一条对象Hash数据 stringRedisTemplate.opsForValue().set("verify:phone:13600527634", "124143"); // 获取string数据 Object name = stringRedisTemplate.opsForValue().get("name"); System.out.println("name = " + name); }
private static final ObjectMapper mapper = new ObjectMapper();
@Test void testSaveUser() throws JsonProcessingException { // 创建对象 User user = new User("虎哥", 21); // 手动序列化 String json = mapper.writeValueAsString(user);
// 写入数据 stringRedisTemplate.opsForValue().set("user:200", json);
// 获取数据 String jsonUser = stringRedisTemplate.opsForValue().get("user:200"); // 手动反序列化 User user1 = mapper.readValue(jsonUser, User.class); System.out.println("user1 = " + user1); }-
使用StringRedisTemplate
-
写入Redis时,手动把对象序列化为JSON writeValueAsString()方法
-
读取Redis时,手动把读取到的JSON反序列化为对象 readValue(获取到的字符串,转化的对象类)方法
// Java + Jedis/Lettuce 示例@Autowiredprivate StringRedisTemplate redisTemplate;
// 1. String - 缓存用户信息public void cacheUser(User user) { String key = "user:" + user.getId(); // 序列化为 JSON String json = JSON.toJSONString(user); redisTemplate.opsForValue().set(key, json, 30, TimeUnit.MINUTES);}
// 2. Hash - 存储商品信息public void cacheGoods(Goods goods) { String key = "goods:" + goods.getId(); Map<String, String> map = new HashMap<>(); map.put("name", goods.getName()); map.put("price", goods.getPrice().toString()); map.put("stock", String.valueOf(goods.getStock()));
redisTemplate.opsForHash().putAll(key, map); redisTemplate.expire(key, 10, TimeUnit.MINUTES);}
// 3. Sorted Set - 排行榜public void updateScore(Long userId, Double score) { String key = "ranking:sales"; redisTemplate.opsForZSet().add(key, userId.toString(), score);}
// 获取 TOP 10public List<Long> getTopUsers(int limit) { String key = "ranking:sales"; Set<String> result = redisTemplate.opsForZSet() .reverseRange(key, 0, limit - 1);
return result.stream() .map(Long::parseLong) .collect(Collectors.toList());}
// 4. List - 消息队列public void pushMessage(String message) { redisTemplate.opsForList().leftPush("queue:message", message);}
public String popMessage() { return redisTemplate.opsForList().rightPop("queue:message");}
// 5. Set - 共同好友public Set<String> getCommonFriends(Long userId1, Long userId2) { String key1 = "friends:" + userId1; String key2 = "friends:" + userId2;
return redisTemplate.opsForSet().intersect(key1, key2);}旁路缓存
更新DB后删缓存
| 方案 | 一致性 | 性能 | 复杂度 | 适用场景 |
|---|---|---|---|---|
| 先更新DB后删缓存 | 最终一致 | ⭐⭐⭐⭐ | ⭐ | ✅ 通用推荐 |
| 延迟双删 | 最终一致 | ⭐⭐⭐ | ⭐⭐ | 读多写少 |
| 读写锁 | 强一致 | ⭐⭐ | ⭐⭐⭐ | 强一致性要求 |
| Canal监听Binlog | 最终一致 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | 高并发、异步 |
| 更新缓存而非删除 | 强一致 | ⭐⭐⭐ | ⭐⭐ | 计算成本低 |
数据一致性
- 先读缓存,缓存未命中再读数据库,然后回写缓存写流程
- 先更新数据库,再删除缓存
先删除缓存,再更新数据库
- 本质先查缓存,缓存中旧值被删除,查数据库查到旧值写入Redis
- 更新数据库,数据库就是新值
先更新数据库,再删除缓存
- 删除缓存前可能读到旧的缓存,但影响较少
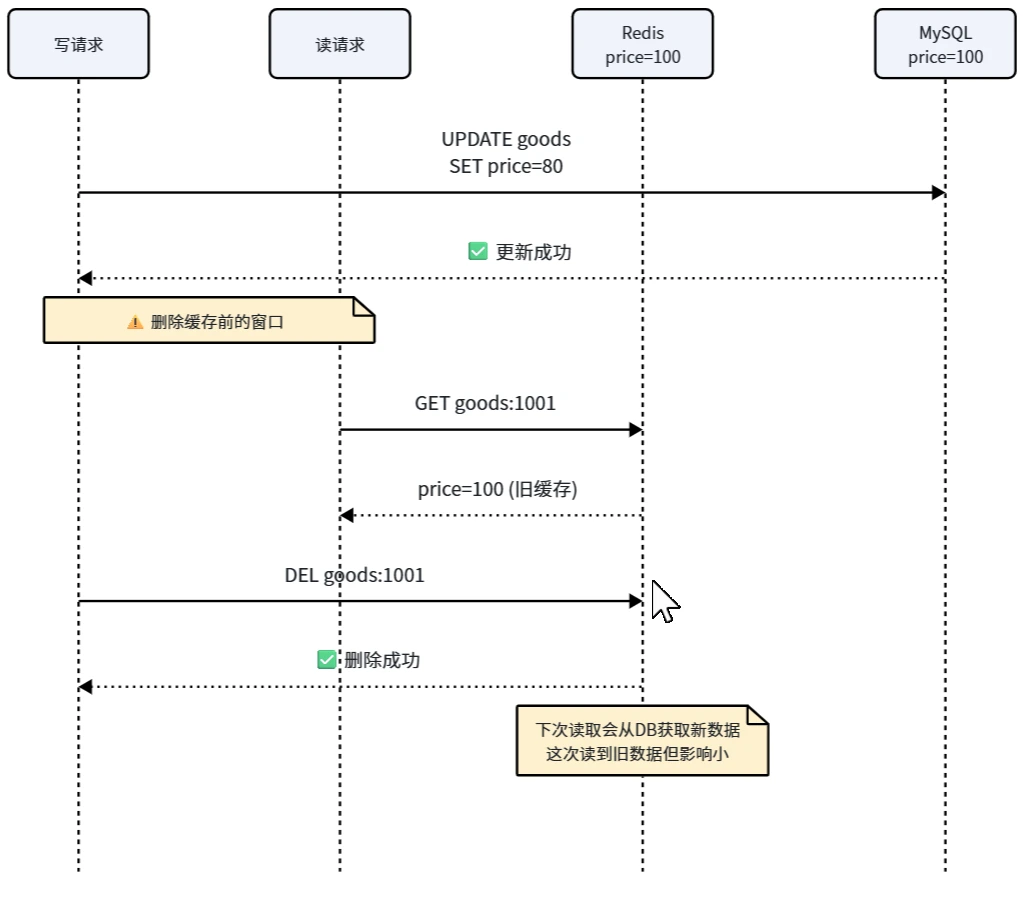
删除缓存失败的概率远小于更新数据库失败 即使删除失败,缓存有过期时间,最终会一致 实现简单,性能好@Servicepublic class GoodsService { @Autowired private GoodsMapper goodsMapper;
@Autowired private StringRedisTemplate redisTemplate;
@Transactional public void updatePrice(Long goodsId, BigDecimal newPrice) { String cacheKey = "goods:" + goodsId;
// 1. 先更新数据库 Goods goods = new Goods(); goods.setId(goodsId); goods.setPrice(newPrice); goodsMapper.updateById(goods);
// 2. 再删除缓存 redisTemplate.delete(cacheKey);
// 为什么不更新缓存? // 1. 删除操作更简单 // 2. 避免并发写入导致的缓存脏数据 // 3. 懒加载:下次读取时再写入最新数据 }
public Goods getGoods(Long goodsId) { String cacheKey = "goods:" + goodsId;
// 1. 查缓存 String json = redisTemplate.opsForValue().get(cacheKey); if (json != null) { return JSON.parseObject(json, Goods.class); }
// 2. 缓存未命中,查数据库 Goods goods = goodsMapper.selectById(goodsId); if (goods == null) { return null; }
// 3. 写入缓存 redisTemplate.opsForValue().set( cacheKey, JSON.toJSONString(goods), 10, TimeUnit.MINUTES );
return goods; }}延迟双删
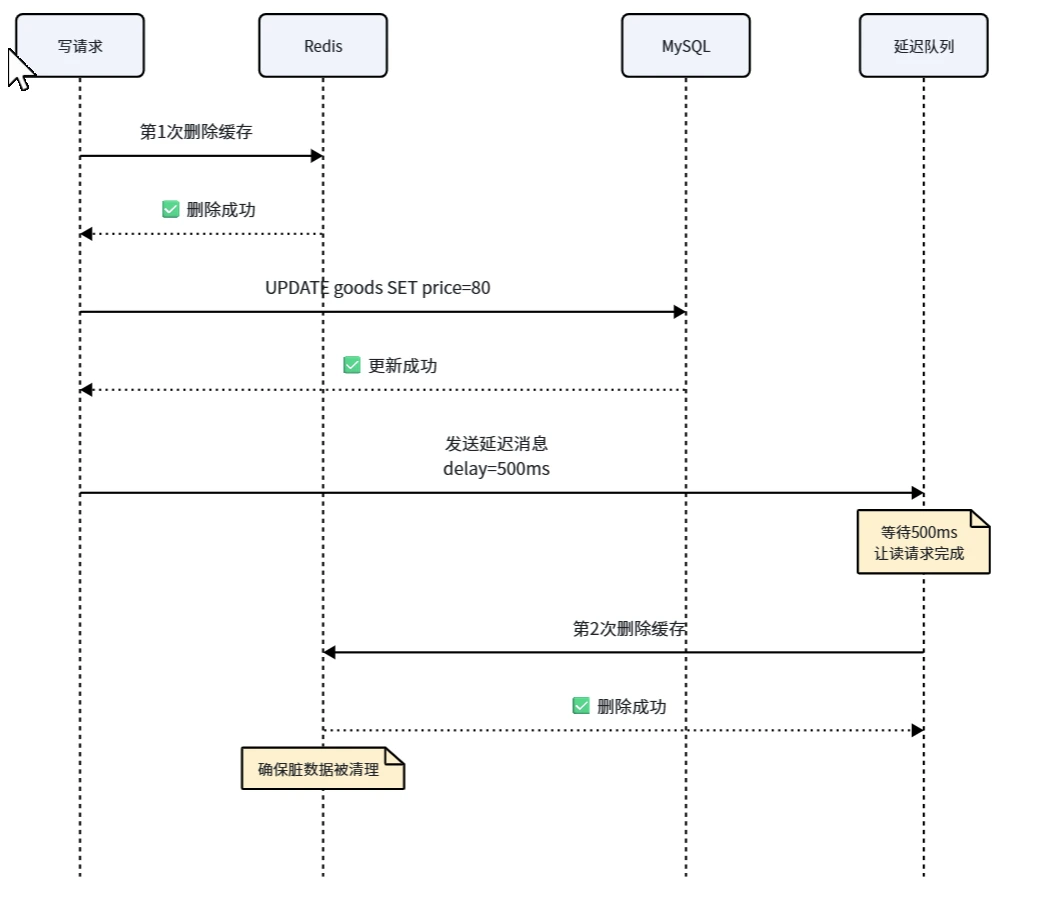
image.webp
@Servicepublic class GoodsService { @Autowired private StringRedisTemplate redisTemplate;
@Autowired private GoodsMapper goodsMapper;
@Transactional public void updatePrice(Long goodsId, BigDecimal newPrice) { String cacheKey = "goods:" + goodsId;
// 1. 第一次删除缓存 redisTemplate.delete(cacheKey);
// 2. 更新数据库 goodsMapper.updatePrice(goodsId, newPrice);
// 3. 延迟双删(异步) CompletableFuture.runAsync(() -> { try { // 延迟 500ms Thread.sleep(500);
// 第二次删除缓存 redisTemplate.delete(cacheKey);
log.info("延迟双删成功: {}", cacheKey); } catch (InterruptedException e) { log.error("延迟双删失败", e); } }); }}- 先删缓存到数据库更新的时间,就会读到旧缓存,再次删除旧缓存,避免旧数据
- 第二次删除也可能失败,建议加重试 / 补偿
延迟时间如何确定
- 根据业务读操作的平均耗时决定
- 一般设置为 300-1000ms
- 可以通过监控统计 99 分位的查询耗时
Canal监听
应用更新MySQL一MySQLBinlog日志一Canal监听一解析BinIog事件------ MQ —删除对应缓存(类似于MySql的主从备份)
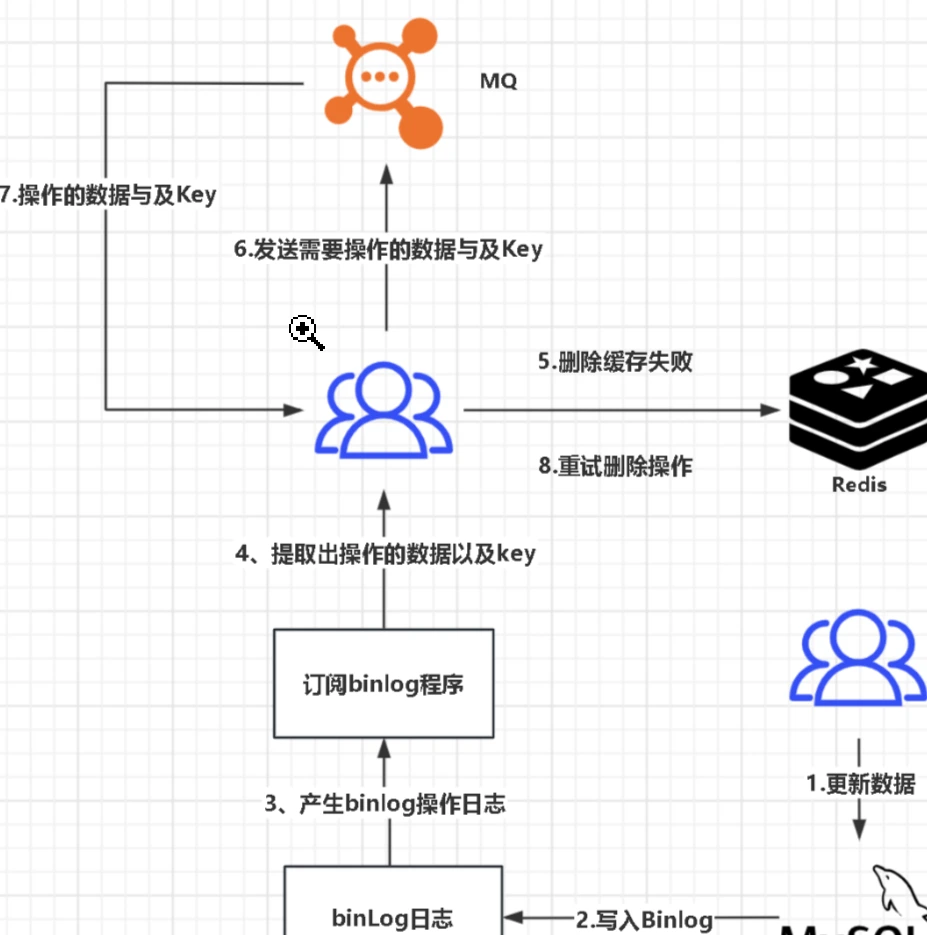
- 业务代码无需关心缓存删除
- 数据库驱动,最终一致性
- 解耦业务逻辑和缓存维护
// Canal 客户端监听器@Componentpublic class CanalListener { @Autowired private StringRedisTemplate redisTemplate;
@CanalListener public void onEvent(CanalEntry.Entry entry) { // 1. 解析 Binlog 事件 String tableName = entry.getHeader().getTableName(); CanalEntry.EventType eventType = entry.getHeader().getEventType();
// 2. 只处理 UPDATE 和 DELETE 事件 if (eventType != CanalEntry.EventType.UPDATE && eventType != CanalEntry.EventType.DELETE) { return; }
// 3. 解析行数据 CanalEntry.RowChange rowChange = CanalEntry.RowChange.parseFrom( entry.getStoreValue() );
for (CanalEntry.RowData rowData : rowChange.getRowDatasList()) { // 获取主键 ID String id = null; for (CanalEntry.Column column : rowData.getAfterColumnsList()) { if (column.getIsKey()) { id = column.getValue(); break; } }
// 4. 删除对应缓存 if (id != null) { String cacheKey = tableName + ":" + id; redisTemplate.delete(cacheKey); log.info("Canal删除缓存: {}", cacheKey); } } }}缓存穿透
缓存空值
缓存和 DB 都没有,请求全部打到数据库
- 查询数据库之前先查询缓存,如果缓存数据存在,则直接从缓存中返回
- 如果缓存数据不存在,再查询数据库,然后将数据存入redis
| 问题 | 现象 | 原因 | 影响 |
|---|---|---|---|
| 缓存穿透 | 查询不存在的数据 | 缓存和 DB 都没有 | 大量请求打到 DB |
| 缓存击穿 | 热点数据过期 | 高并发访问过期 key | 瞬间压垮 DB |
| 缓存雪崩 | 大量 key 同时过期 | 过期时间设置相同 | DB 瞬间压力激增 |
| 方案 | 实现方式 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| 缓存空值 | 不存在也缓存 null | 简单有效 | 占用内存 | ✅ 通用推荐 |
| 布隆过滤器 | Bitmap 判断存在性 | 内存占用小 | 有误判率 | 海量数据 |
| 参数校验 | 前置拦截非法参数 | 性能最好 | 无法防止合法 ID 穿透 | 配合其他方案 |
请求查询商品 ↓[1] 查缓存 → 命中? ├─ 是 → 值是空字符串?→ 返回 null(防穿透) └─ 否 → 值是正常JSON → 反序列化返回商品对象 ↓[2] 缓存未命中 → 查数据库 ├─ 查到商品 → 缓存JSON,过期10分钟 → 返回商品 └─ 没查到 → 缓存空字符串,过期2分钟 → 返回null- JSON.parseObject(json, Goods.class);和Shop shop =JSONUtil.toBean(shopJson,Shop.class);Redis的String格式转换为对象
- stringRedisTemplate.opsForValue().set(key,JSONUtil.toJsonStr(shop));将 Bean 等对象转换为 String类型,内容格式为JSon
public Goods getGoods(Long goodsId) { String cacheKey = "goods:" + goodsId;
// 1. 查缓存 String json = redisTemplate.opsForValue().get(cacheKey);
// 缓存命中 if (json != null) { // 如果是空字符串,说明数据不存在 if ("".equals(json)) { return null; } return JSON.parseObject(json, Goods.class); }
// 2. 查数据库 Goods goods = goodsMapper.selectById(goodsId);
if (goods != null) { // 3.1 数据存在,缓存正常对象 redisTemplate.opsForValue().set( cacheKey, JSON.toJSONString(goods), 10, TimeUnit.MINUTES ); } else { // 3.2 数据不存在,缓存空字符串,过期时间短一些 redisTemplate.opsForValue().set( cacheKey, "", 2, TimeUnit.MINUTES ); }
return goods;}- 空值时间设置较短节省内存
- 定期清理空值缓存
布隆过滤器
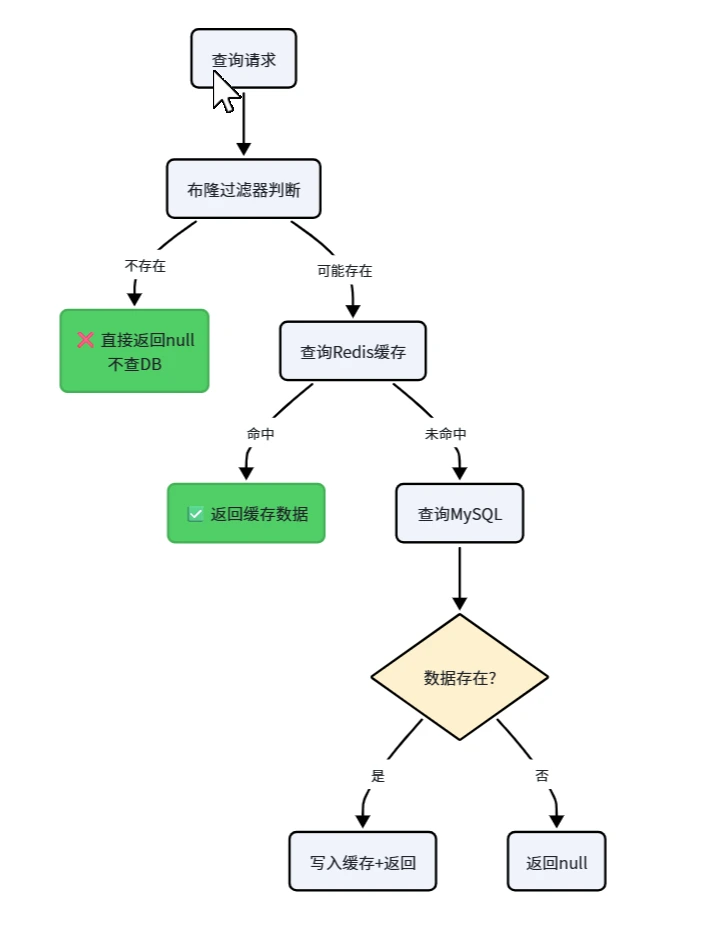
- 用多个哈希函数将元素映射到位数组
- 查询时检查所有位是否都为1
- 不存在:100%准确
- 存在:有一定误判率(可配置)
Redission实现
@Configurationpublic class BloomFilterConfig { @Bean public RBloomFilter<Long> goodsBloomFilter(RedissonClient redisson) { RBloomFilter<Long> bloomFilter = redisson.getBloomFilter("goods:bloom"); // 预计元素数量 1000万,误判率 0.01 bloomFilter.tryInit(10000000L, 0.01); return bloomFilter; }
@PostConstruct public void initBloomFilter() { List<Long> allGoodsIds = goodsMapper.selectAllIds(); for (Long id : allGoodsIds) { goodsBloomFilter.add(id); } log.info("布隆过滤器初始化完成,加载商品数: {}", allGoodsIds.size()); }}
@Servicepublic class GoodsService { @Autowired private RBloomFilter<Long> goodsBloomFilter;
public Goods getGoods(Long goodsId) { // 1. 先用布隆过滤器判断 if (!goodsBloomFilter.contains(goodsId)) { // 100% 不存在 return null; }
// 2. 可能存在,继续查缓存和DB String cacheKey = "goods:" + goodsId; String json = redisTemplate.opsForValue().get(cacheKey); if (json != null) { return JSON.parseObject(json, Goods.class); }
Goods goods = goodsMapper.selectById(goodsId); if (goods != null) { redisTemplate.opsForValue().set( cacheKey, JSON.toJSONString(goods), 10, TimeUnit.MINUTES ); }
return goods; }
// 新增商品时添加到布隆过滤器 public void addGoods(Goods goods) { goodsMapper.insert(goods); goodsBloomFilter.add(goods.getId()); }}- 布隆过滤器不支持删除(需要用countingBloomFilter)
- 需要在应用启动时加载所有数据
- 新增数据要同步更新布隆过滤器
缓存击穿
互斥锁
热点数据过期(热点Key)时,大量并发请求同时打到数据库
- 查询数据库写入redis时间过长,另一个线程也未命中并查询数据库
- 很多线程同时去查数据库并尝试重建缓存,压垮数据库。
缓存未命中使用互斥锁,确保同一时间只有一个线程重建缓存
-
trylock方法利用redis的setnx命令,若key不存在,才进行插入操作返回bolean值
-
False拿到锁的线程去查库重建缓存;True拿不到的线程休眠重试。
-
优缺点:优点是保证了数据的一致性,实现较简单;缺点是互相等待导致性能下降,且有死锁风险。
互斥锁的影响
- 锁能实现互斥性。假设线程过来,只能一个人一个人的来访问数据库,从而避免对于数据库访问压力过大
- 影响查询的性能,查询的性能从并行变成了串行,采用tryLock方法 + double check来解决这样的问题。
| 方案 | 实现方式 | 优点 | 缺点 |
|---|---|---|---|
| 互斥锁 | 只有一个线程查DB | 保证只查一次DB | 其他线程等待 |
| 逻辑过期 | 缓存永不过期 | 无等待 | 可能读到旧数据 |
| 热点数据预加载 | 提前刷新缓存 | 用户无感知 | 需要识别热点 |
public Goods getGoods(Long goodsId) { String cacheKey = "goods:" + goodsId;
// 1. 查缓存 String json = redisTemplate.opsForValue().get(cacheKey); if (json != null) { return JSON.parseObject(json, Goods.class); }
// 2. 缓存未命中,加互斥锁 String lockKey = "lock:goods:" + goodsId;
try { // 尝试获取锁,10秒超时 Boolean locked = redisTemplate.opsForValue() .setIfAbsent(lockKey, "1", 10, TimeUnit.SECONDS);
if (Boolean.TRUE.equals(locked)) { // 3. 获取锁成功,查数据库 Goods goods = goodsMapper.selectById(goodsId);
if (goods != null) { // 4. 写入缓存 redisTemplate.opsForValue().set( cacheKey, JSON.toJSONString(goods), 10, TimeUnit.MINUTES ); } return goods; } else { // 5. 获取锁失败,等待一下再重试 Thread.sleep(50); return getGoods(goodsId); // 递归重试 }
} catch (InterruptedException e) { throw new RuntimeException(e); } finally { // 6. 释放锁 redisTemplate.delete(lockKey); }}Redission优化
@Autowiredprivate RedissonClient redisson;
public Goods getGoods(Long goodsId) { String cacheKey = "goods:" + goodsId;
// 1. 查缓存 String json = redisTemplate.opsForValue().get(cacheKey); if (json != null) { return JSON.parseObject(json, Goods.class); }
// 2. 缓存未命中,使用 Redisson 锁 String lockKey = "lock:goods:" + goodsId; RLock lock = redisson.getLock(lockKey);
try { // 尝试加锁,最多等待5秒,锁10秒后自动释放 if (lock.tryLock(5, 10, TimeUnit.SECONDS)) { // 3. 双重检查:再次查缓存(可能其他线程已写入) json = redisTemplate.opsForValue().get(cacheKey); if (json != null) { return JSON.parseObject(json, Goods.class); }
// 4. 查数据库 Goods goods = goodsMapper.selectById(goodsId);
if (goods != null) { // 5. 写入缓存 redisTemplate.opsForValue().set( cacheKey, JSON.toJSONString(goods), 10, TimeUnit.MINUTES ); }
return goods; } else { // 获取锁失败,返回错误或默认值 throw new RuntimeException("系统繁忙,请稍后重试"); } } catch (InterruptedException e) { throw new RuntimeException(e); } finally { if (lock.isHeldByCurrentThread()) { lock.unlock(); } }}逻辑过期
- 原理:不给Key设置实际的TTL,而是在Value中存入一个“逻辑过期时间”字段
- 优缺点:优点是线程不阻塞,并发性能极高;缺点是牺牲了短期的一致性(重构完成前返回的都是脏数据),且实现较复杂。
实现方法
- 设计缓存包装类真实数据和逻辑过期时间时间戳System.currentTimeMillis() > expireTime
- 一旦命中后,将value取出,判断value中的过期时间是否满足,如果没有过期,则直接返回redis中的数据
- 发现过期时,当前线程直接返回旧数据(脏数据),
- 开启一个独立新线程去获取互斥锁并异步查库重建缓存,重构完成后释放互斥锁,
// 缓存对象包装类@Datapublic class CacheData<T> { private T data; // 真实数据 private Long expireTime; // 逻辑过期时间(时间戳)
查到redis数据,利用方法看下是否过期,过期 public boolean isExpired() { return System.currentTimeMillis() > expireTime; }}public Goods getGoods(Long goodsId) { String cacheKey = "goods:" + goodsId;
// 1. 查缓存(缓存永不过期) String json = redisTemplate.opsForValue().get(cacheKey);
if (json == null) { // 缓存不存在,直接查DB并写入(首次访问) return loadAndCache(goodsId); }
// 2. 从Redis里查到数据,解析缓存数据 CacheData<Goods> cacheData = JSON.parseObject(json, new TypeReference<CacheData<Goods>>() {});
// 3. 检查逻辑过期时间 if (!cacheData.isExpired()) { // 未过期,直接返回 return cacheData.getData(); }
// 4. 已过期,异步刷新缓存 String lockKey = "lock:refresh:" + goodsId; Boolean locked = redisTemplate.opsForValue() .setIfAbsent(lockKey, "1", 10, TimeUnit.SECONDS);
if (Boolean.TRUE.equals(locked)) { // 获取锁成功,异步刷新 CompletableFuture.runAsync(() -> { try { //查询数据库,存入新数据进入Redis loadAndCache(goodsId); } finally { redisTemplate.delete(lockKey); } }); }
// 5. 返回旧数据(用户无感知) return cacheData.getData();}
private Goods loadAndCache(Long goodsId) { String cacheKey = "goods:" + goodsId;
// 查数据库 Goods goods = goodsMapper.selectById(goodsId);
if (goods != null) { // 包装为逻辑过期对象 CacheData<Goods> cacheData = new CacheData<>(); cacheData.setData(goods); cacheData.setExpireTime( System.currentTimeMillis() + 10 * 60 * 1000 // 10分钟后逻辑过期 );
// 写入缓存(不设置过期时间) redisTemplate.opsForValue().set( cacheKey, JSON.toJSONString(cacheData) ); }
return goods;}逻辑过期的优点:
-
无锁等待,性能最好
-
缓存永不过期,不会出现击穿
-
异步刷新,用户无感知
缺点:
-
可能返回过期数据(适用于允许短暂不一致的场景)
-
内存占用较高(缓存永不删除)
缓存雪崩
TTL随机
大量缓存在同一时间过期,导致请求瞬间打到数据库
| 方案 | 实现方式 | 优点 | 缺点 |
|---|---|---|---|
| 过期时间加随机值 | TTL + random | 简单有效 | - |
| 热点数据永不过期 | 逻辑过期 | 彻底解决 | 占用内存 |
| 限流降级 | Sentinel/Hystrix | 保护DB | 部分请求失败 |
| 多级缓存 | 本地缓存 + Redis | 提升可用性 | 复杂度高 |
public void cacheGoods(Goods goods) { String cacheKey = "goods:" + goods.getId(); String json = JSON.toJSONString(goods);
// 基础过期时间 10 分钟 long baseExpire = 10 * 60;
// 加上随机时间 0-5 分钟 long randomExpire = ThreadLocalRandom.current().nextLong(0, 5 * 60);
// 实际过期时间 = 10~15 分钟随机 redisTemplate.opsForValue().set( cacheKey, json, baseExpire + randomExpire, TimeUnit.SECONDS );}缓存预热
- @PostConstrust这个类被Spring创建完成,对象已经被创建,依赖注入完成后自动执行
- @Bean属于对象还没被创建,执行方法后交由Spring容器里的bean
// 项目启动时预热热点数据@Componentpublic class CacheWarmer { @Autowired private GoodsMapper goodsMapper;
@Autowired private StringRedisTemplate redisTemplate;
@PostConstruct public void warmUpCache() { // 1. 查询热门商品(如销量TOP 1000) List<Goods> hotGoods = goodsMapper.selectHotGoods(1000);
// 2. 写入缓存,过期时间随机 for (Goods goods : hotGoods) { String cacheKey = "goods:" + goods.getId(); String json = JSON.toJSONString(goods);
// 过期时间:30分钟 + 0~10分钟随机 long expireTime = 30 * 60 + ThreadLocalRandom.current().nextLong(0, 10 * 60);
redisTemplate.opsForValue().set( cacheKey, json, expireTime, TimeUnit.SECONDS ); }
log.info("缓存预热完成,加载商品数: {}", hotGoods.size()); }}多级缓存
Caffeine + Redis 两级缓存:
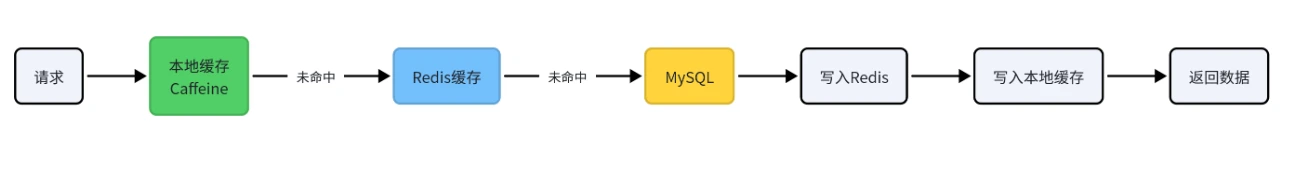
@Configurationpublic class CacheConfig { @Bean public Cache<String, String> localCache() { return Caffeine.newBuilder() .maximumSize(10000) // 最多缓存10000个 .expireAfterWrite(5, TimeUnit.MINUTES) // 5分钟过期 .recordStats() // 启用统计 .build(); }}
@Servicepublic class GoodsService { @Autowired private Cache<String, String> localCache;
@Autowired private StringRedisTemplate redisTemplate;
@Autowired private GoodsMapper goodsMapper;
public Goods getGoods(Long goodsId) { String cacheKey = "goods:" + goodsId;
// 1. 查本地缓存 String json = localCache.getIfPresent(cacheKey); if (json != null) { return JSON.parseObject(json, Goods.class); }
// 2. 查 Redis 缓存 json = redisTemplate.opsForValue().get(cacheKey); if (json != null) { // 写入本地缓存 localCache.put(cacheKey, json); return JSON.parseObject(json, Goods.class); }
// 3. 查数据库 Goods goods = goodsMapper.selectById(goodsId); if (goods != null) { json = JSON.toJSONString(goods);
// 写入 Redis redisTemplate.opsForValue().set( cacheKey, json, 10, TimeUnit.MINUTES );
// 写入本地缓存 localCache.put(cacheKey, json); }
return goods; }}多级缓存的优点:
-
即使 Redis 挂了,本地缓存仍可用
-
减少网络开销,性能更好
-
提升系统可用性
缺点:
-
数据一致性更难保证
-
本地缓存占用应用内存
-
需要处理缓存失效通知
IO多路复用
初识
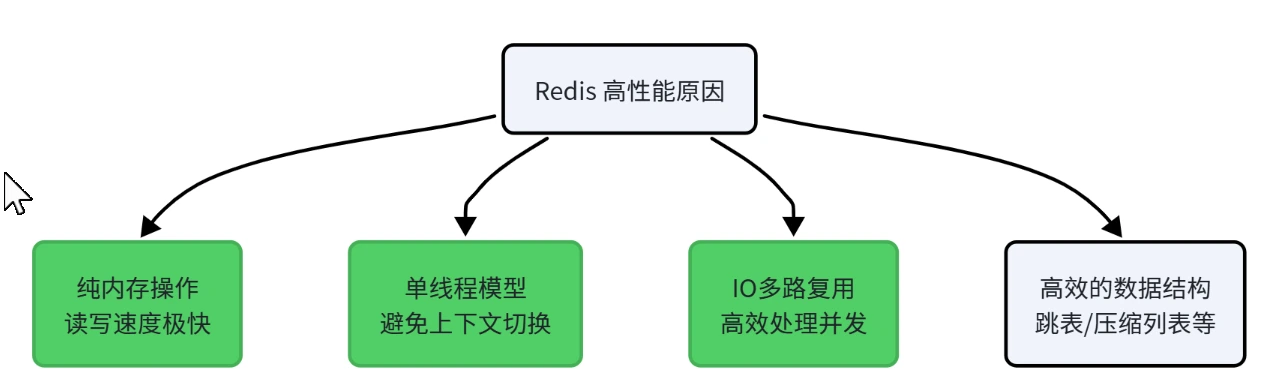
一个线程管理多个连接
-
Redis 6.0 之前是单线程(处理命令)
-
Redis 6.0 之后引入多线程 IO(网络读写)
-
核心命令执行仍是单线程
Epoll
客户端连接,事件注册到epoll可监听事件,事件循环,事件已就绪,添加到事件就绪列表并遍历,读取执行命令
// 1. 创建 epoll 实例int epfd = epoll_create(1024);
// 2. 注册监听的文件描述符struct epoll_event ev;ev.events = EPOLLIN; // 监听可读事件ev.data.fd = client_fd;epoll_ctl(epfd, EPOLL_CTL_ADD, client_fd, &ev);
// 3. 等待事件就绪struct epoll_event events[MAX_EVENTS];int nfds = epoll_wait(epfd, events, MAX_EVENTS, timeout);
// 4. 处理就绪事件for (int i = 0; i < nfds; i++) { if (events[i].events & EPOLLIN) { // 读取数据 read(events[i].data.fd, buffer, sizeof(buffer)); // 处理命令 process_command(buffer); }}事件循环
def redis_event_loop(): # 创建 epoll 实例 epoll_fd = epoll_create()
# 监听服务端口 listen_fd = socket.socket() listen_fd.bind(('0.0.0.0', 6379)) listen_fd.listen(128)
# 注册监听 socket epoll_ctl(epoll_fd, EPOLL_CTL_ADD, listen_fd, EPOLLIN)
# 事件循环 while True: # 等待事件就绪(超时时间很短,避免阻塞过期key清理等任务) ready_events = epoll_wait(epoll_fd, timeout=10ms)
for event in ready_events: if event.fd == listen_fd: # 新连接到达 client_fd = accept(listen_fd) # 注册客户端 socket epoll_ctl(epoll_fd, EPOLL_CTL_ADD, client_fd, EPOLLIN)
else: # 客户端数据就绪 command = read(event.fd)
# 执行 Redis 命令(单线程执行) result = execute_command(command)
# 写回响应 write(event.fd, result)
# 处理其他定时任务 handle_expired_keys() # 清理过期key handle_aof_rewrite() # AOF重写单线程
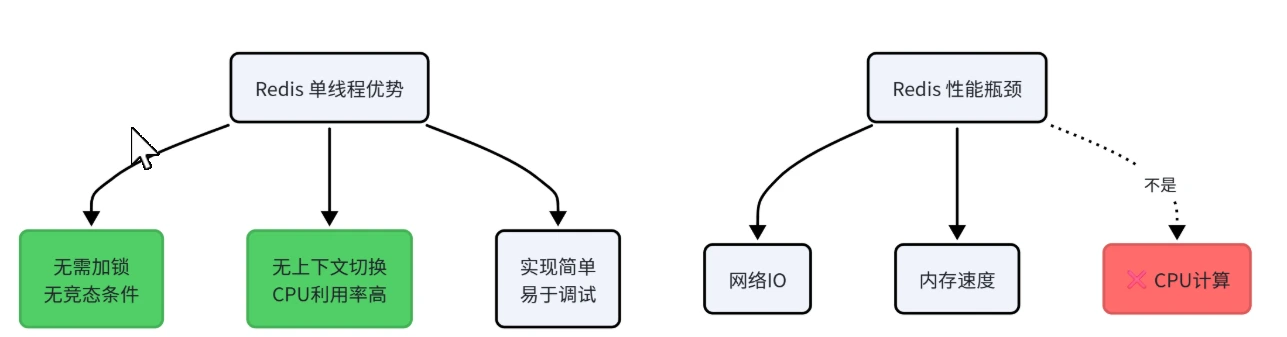
核心观点:
-
Redis 的瓶颈不在 CPU,在网络和内存
-
单线程避免了锁的开销和复杂性
-
通过 IO 多路复用实现高并发
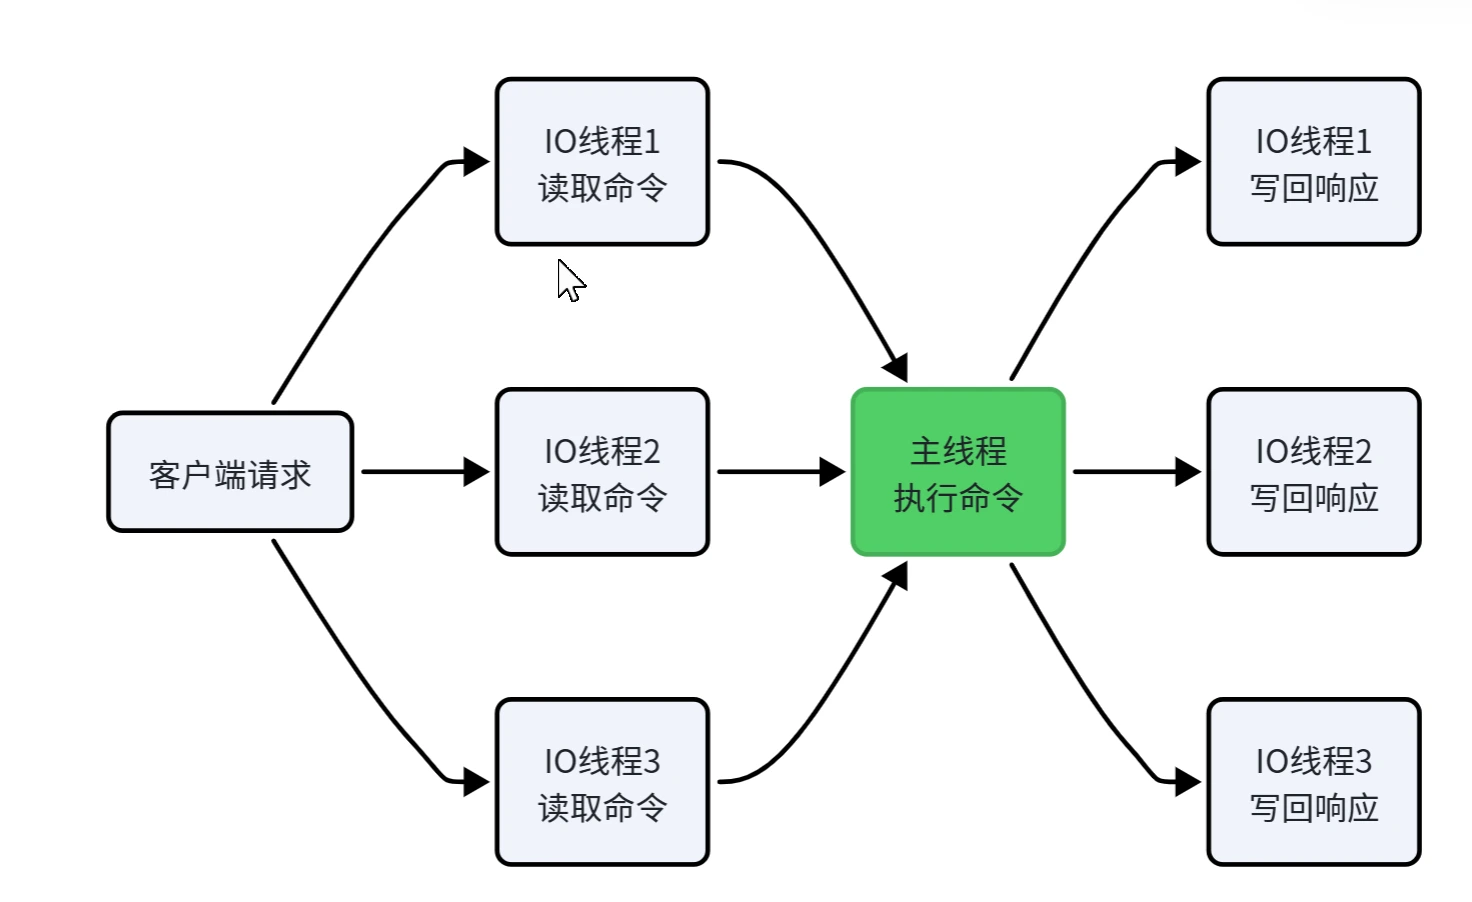
注意:
-
只有网络 IO 是多线程
-
命令执行仍是单线程
-
需要手动开启:
io-threads 4
Lua脚本
库存扣减
并发问题:存在时间窗口,多条Redis命令组合无法保证原子性,无法保证原子性
- 原子性:脚本执行不被打断
- 减少网络开销:多条命令一次传输
- 复用性:脚本可以缓存
-- KEYS[1]: 库存key-- ARGV[1]: 扣减数量
local stock_key = KEYS[1]local quantity = tonumber(ARGV[1])
-- 获取当前库存local stock = tonumber(redis.call('GET', stock_key) or '0')
-- 判断库存是否充足if stock >= quantity then -- 扣减库存 redis.call('DECRBY', stock_key, quantity) return stock - quantity -- 返回剩余库存else return -1 -- 库存不足end@Servicepublic class GoodsService { @Autowired private StringRedisTemplate redisTemplate;
// Lua 脚本内容 private static final String STOCK_DEDUCT_SCRIPT = "local stock_key = KEYS[1]\n" + "local quantity = tonumber(ARGV[1])\n" + "local stock = tonumber(redis.call('GET', stock_key) or '0')\n" + "if stock >= quantity then\n" + " redis.call('DECRBY', stock_key, quantity)\n" + " return stock - quantity\n" + "else\n" + " return -1\n" + "end";
public Result<Order> createOrder(Long goodsId, Integer quantity) { String stockKey = "goods:stock:" + goodsId; //创建 Spring Redis 的 Lua 脚本对象 DefaultRedisScript<Long> script = new DefaultRedisScript<>();
/Lua脚本放置的位置 script.setScriptText(STOCK_DEDUCT_SCRIPT); script.setResultType(Long.class); // 执行 Lua 脚本 Long remainStock = redisTemplate.execute( script, //Collections.singletonList 创建一个只包含一个元素的 List Collections.singletonList(stockKey), // KEYS quantity.toString() // ARGV );
if (remainStock < 0) { return Result.fail("库存不足"); }
// 创建订单 Order order = createOrderRecord(goodsId, quantity);
return Result.success(order); }}限流器
同一个用户,在最近 window 秒内,最多允许 maxRequests 次请求。例如“10 秒内最多 100 次”,这里的 10 秒会随着每次请求向前滑动,所以叫滑动窗口限流
-- 滑动窗口限流-- KEYS[1]: 限流key-- ARGV[1]: 窗口大小(秒)-- ARGV[2]: 最大请求数-- ARGV[3]: 当前时间戳
local key = KEYS[1]local window = tonumber(ARGV[1])local max_requests = tonumber(ARGV[2])local now = tonumber(ARGV[3])
//现在是第 20 秒,窗口是 10 秒,就删除时间不晚于第 10 秒的记录。剩下的就是最近 10 秒内的请求。-- 移除窗口之外的请求redis.call('ZREMRANGEBYSCORE', key, 0, now - window * 1000)
-- 统计窗口内的请求数local current = redis.call('ZCARD', key)
if current < max_requests then -- 允许请求,记录时间戳 redis.call('ZADD', key, now, now) redis.call('EXPIRE', key, window) --每次成功请求都会重新设置 return 1 -- 允许通过else return 0 -- 限流end@Componentpublic class RateLimiter { @Autowired private StringRedisTemplate redisTemplate;
private static final String RATE_LIMIT_SCRIPT = "..."; // Lua脚本
/** * 限流检查 * @param key 限流key(如:rate:limit:user:1001) * @param window 时间窗口(秒) * @param maxRequests 最大请求数 * @return true-允许,false-限流 */ public boolean tryAcquire(String key, int window, int maxRequests) { DefaultRedisScript<Long> script = new DefaultRedisScript<>(); script.setScriptText(RATE_LIMIT_SCRIPT); script.setResultType(Long.class);
Long result = redisTemplate.execute( script, Collections.singletonList(key), KEYS[1] String.valueOf(window), ARGV[1]: 窗口大小(秒) String.valueOf(maxRequests), 最大请求数 String.valueOf(System.currentTimeMillis()) 当前时间戳 );
return result != null && result == 1; }}
// 使用示例@RestControllerpublic class ApiController { @Autowired private RateLimiter rateLimiter;
@GetMapping("/api/data") public Result getData(@RequestHeader("userId") Long userId) { String limitKey = "rate:limit:user:" + userId;
// 限流:10秒内最多100次请求 if (!rateLimiter.tryAcquire(limitKey, 10, 100)) { return Result.fail("请求过于频繁,请稍后重试"); }
// 正常业务逻辑 return Result.success(dataService.getData()); }}脚本缓存
- @Configuration注解标记配置类,Sprng启动时进行扫描,告诉Spring这是一个Bean工厂,Bean之间有依赖
- @Bean注解会执行返回对象DefaultRedisScript
交由Spring容器里的bean - @Qulifier(“@Bean的方法名”)如果有多个相同的返回对象类型
@Configurationpublic class LuaScriptConfig { @Bean public DefaultRedisScript<Long> stockDeductScript() { DefaultRedisScript<Long> script = new DefaultRedisScript<>();
// 从文件加载脚本 script.setLocation(new ClassPathResource("lua/stock_deduct.lua")); script.setResultType(Long.class);
return script; }}
@Servicepublic class GoodsService { @Autowired @Qualifier("stockDeductScript") private DefaultRedisScript<Long> stockDeductScript;
public Result<Order> createOrder(Long goodsId, Integer quantity) { String stockKey = "goods:stock:" + goodsId;
// 直接使用预加载的脚本 Long remainStock = redisTemplate.execute( stockDeductScript, Collections.singletonList(stockKey), quantity.toString() );
if (remainStock < 0) { return Result.fail("库存不足"); }
return Result.success(createOrderRecord(goodsId, quantity)); }}| 对比项 | static 静态代码块 | @Configuration + @Bean |
|---|---|---|
| 初始化时机 | 类首次被 JVM 初始化时执行一次;不一定早于 Spring 启动 | Spring 创建该 Bean 时初始化;默认是单例 |
| 管理者 | JVM 管理类的静态成员 | Spring 容器管理 Bean |
| 使用方式 | 在本类中直接访问静态变量 | 在需要的类中注入 Bean |
| 跨类复用 | 可以暴露静态成员,但会增加对具体类的依赖 | 可按 Bean 名称或类型注入,复用更方便 |
使用 yml 配置 | 静态块不能直接注入 Spring 配置;需要额外获取或传递配置 | 可通过配置属性动态选择脚本路径 |
| 条件化加载 | 需要自己编写判断逻辑 | 可配合 @Conditional、@Profile 等 |
| 多脚本管理 | 容易分散在不同业务类中 | 可集中定义,统一命名和维护 |
| 异常处理 | 静态初始化失败可能导致类初始化失败,排查较麻烦 | 可记录日志并给出明确的启动失败原因;异常不会自动变得可恢复 |
| 代码量 | 少,适合局部使用 | 需要配置和注入代码 |
| 适用场景 | 脚本少、路径固定、只在当前类使用 | 脚本较多、需要跨类复用或根据配置切换 |
| 注解 | 标注位置 | 核心作用 | 配置模式 | 是否代理本类中的 @Bean 方法 | 本类内部直接调用 @Bean 方法 | 适用场景 |
|---|---|---|---|---|---|---|
@Component | 类上 | 将这个类本身注册为 Spring Bean | Lite | 否 | 普通 Java 方法调用,会执行方法体;若方法里写了 new,就会创建新对象 | 普通组件;类中只有少量、互不调用的 @Bean 方法 |
@Configuration | 类上 | 声明专门定义 Bean 的配置类;它本身也是 Spring 组件 | 默认 Full | 默认会通过 CGLIB 增强 | 调用会被拦截,通常从容器取得已有的单例 Bean | 集中管理 Bean;@Bean 方法之间需要直接调用 |
@Bean | 方法上 | 将方法的返回对象注册为 Spring Bean,默认作用域为单例 | 取决于所在类 | 自身不决定是否代理 | 行为取决于所在类是否启用 Full 模式 | 注册第三方类或需要自定义创建过程的对象,如 DefaultRedisScript、RedisTemplate |
分布式锁
基本实现
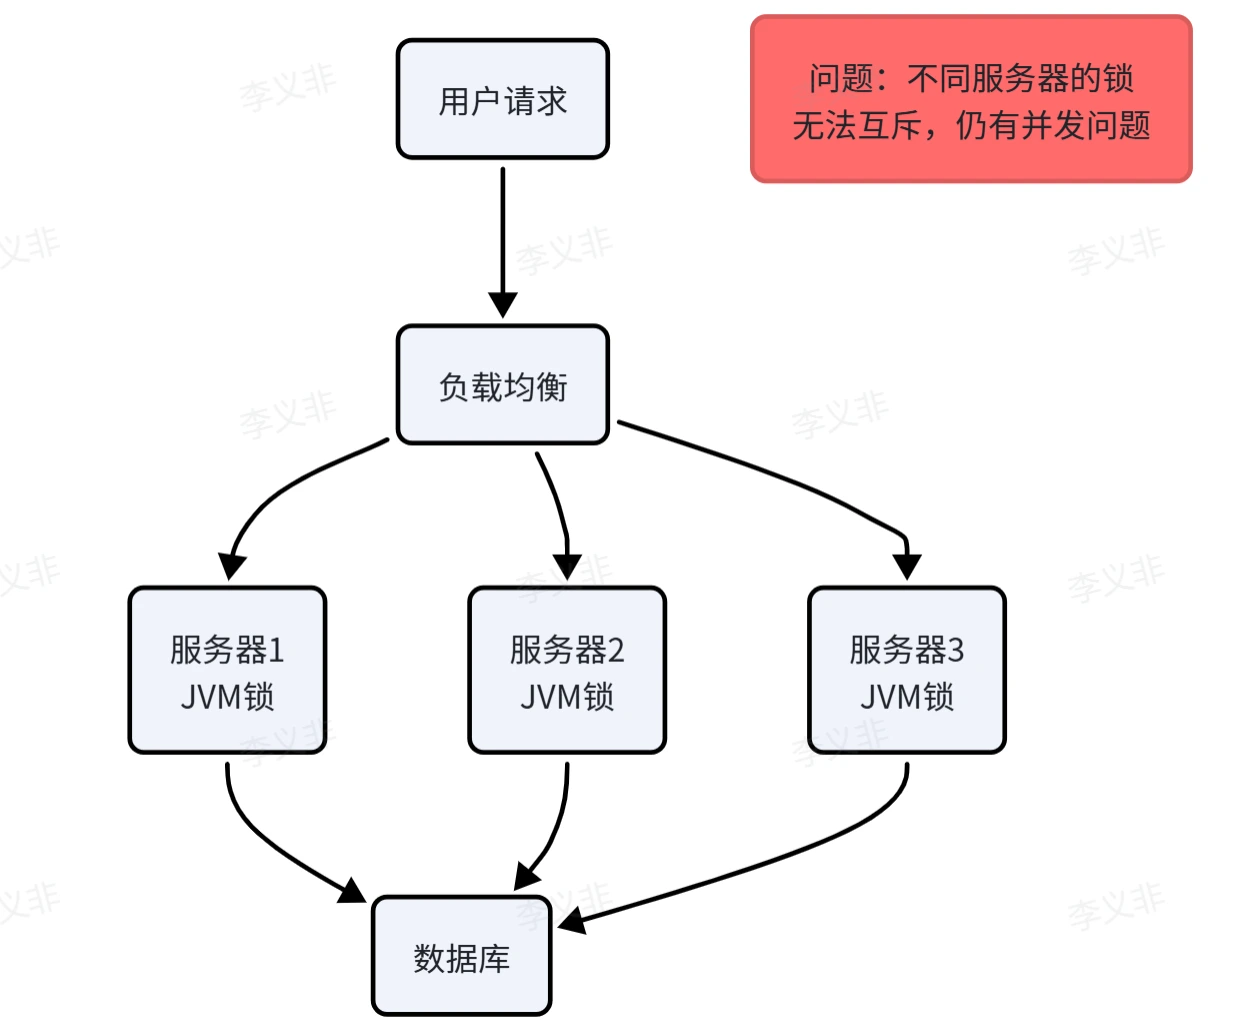
| 方案 | 实现方式 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| Redis SETNX | SET key NX EX | 性能高,实现简单 | 需要处理锁超时 | ✅ 通用推荐 |
| Redisson | Redisson框架 | 功能完善,自动续期 | 依赖额外组件 | ✅ 生产推荐 |
| Zookeeper | 临时顺序节点 | 强一致性 | 性能较差,重量级 | CP场景 |
| 数据库 | SELECT FOR UPDATE | 简单 | 性能最差 | 低并发 |
- (区分用户)Key为统一锁前缀 + 具体业务锁名称lock:order
- (区分不同的JVM)Value为UUID+Thread.currentThread().getId()两台应用服务器上都可能有 ID 为
23的线程定义Redis的Value值,
@Servicepublic class DistributedLockService { @Autowired private StringRedisTemplate redisTemplate;
/** * 尝试加锁 * @param lockKey 锁的key * @param value 锁的值(通常用UUID,防止误删) * @param expireTime 过期时间(秒) * @return true-加锁成功,false-加锁失败 */ public boolean tryLock(String lockKey, String value, long expireTime) { Boolean result = redisTemplate.opsForValue() .setIfAbsent(lockKey, value, expireTime, TimeUnit.SECONDS);
return Boolean.TRUE.equals(result); }
/** * 释放锁 */ public void unlock(String lockKey, String value) { String currentValue = redisTemplate.opsForValue().get(lockKey);
// 只能删除自己加的锁 if (value.equals(currentValue)) { redisTemplate.delete(lockKey); } }}
// 使用示例public Result<Order> createOrder(Long goodsId) { String lockKey = "lock:order:" + goodsId; String lockValue = UUID.randomUUID().toString();
// 尝试加锁,10秒过期 boolean locked = lockService.tryLock(lockKey, lockValue, 10);
if (!locked) { return Result.fail("系统繁忙,请稍后重试"); }
try { // 执行业务逻辑 return orderService.create(goodsId); } finally { // 释放锁 lockService.unlock(lockKey, lockValue); }}锁误删
- 获取Value后确定为线程A,恰好线程A过期,此时线程B进入被删除了同名锁(Lock:order
) - 查看和对比应该是原子性命令,使用Lua脚本执行redisTemplate.execute()
public class DistributedLockService { // Lua 脚本:先判断再删除 private static final String UNLOCK_SCRIPT = "if redis.call('GET', KEYS[1]) == ARGV[1] then\n" + " return redis.call('DEL', KEYS[1])\n" + "else\n" + " return 0\n" + "end";
public void unlock(String lockKey, String value) { DefaultRedisScript<Long> script = new DefaultRedisScript<>(); script.setScriptText(UNLOCK_SCRIPT); script.setResultType(Long.class);
redisTemplate.execute( script, Collections.singletonList(lockKey), value ); }}Redission
配置
- 超时释放导致的问题
- 锁加上了过期时间,这就造成了可能线程还未执行完业务就把锁释放了,其他线程就可以拿到锁乘虚而入,这是我们尚未解决的
<dependency> <groupId>org.redisson</groupId> <artifactId>redisson</artifactId> <version>3.13.6</version></dependency>@Configurationpublic class RedissonConfig { @Bean public RedissonClient redissonClient() { Config config = new Config();
// 单机模式 config.useSingleServer() .setAddress("redis://localhost:6379") .setPassword("your_password") .setDatabase(0) .setConnectionPoolSize(50) .setConnectionMinimumIdleSize(10);
return Redisson.create(config); }}@Servicepublic class OrderService { @Autowired private RedissonClient redisson;
public Result<Order> createOrder(Long goodsId) { String lockKey = "lock:order:" + goodsId;
RLock lock = redisson.getLock(lockKey); try { // 尝试加锁 // waitTime: 最多等待5秒 // leaseTime: 锁自动释放时间10秒 boolean locked = lock.tryLock(5, 10, TimeUnit.SECONDS);
if (!locked) { return Result.fail("系统繁忙,请稍后重试"); }
// 执行业务逻辑 Order order = createOrderRecord(goodsId);
return Result.success(order);
} catch (InterruptedException e) { return Result.fail("操作被中断"); } finally { // 释放锁(只释放自己持有的锁) if (lock.isHeldByCurrentThread()) { lock.unlock(); } } }}看门狗
业务开始运行 -> 拿到 30 秒的锁 -> 过了 10 秒 -> 看门狗醒来,把锁恢复到 30 秒 -> 又过 10 秒 -> 看门狗醒来,又恢复到 30 秒… 只要你的业务没调用 unlock(),这个心跳就会永远跳动下去
- waitTime是抢锁前最多等多久,leaseTime 是抢到后持有多久
- 看门狗实现看是否显式指定leaseTime,显示则不启用
tryLock(waitTime, unit)tryLock(waitTime, leaseTime, unit)lock(leaseTime, unit)lock.lock(10, TimeUnit.SECONDS) (带时间参数)
- 底层逻辑:你显式传入了 leaseTime(大于 0)。Redisson 会绝对服从你的指令,将锁的过期时间设置为 10 秒。
- 致命后果:看门狗机制将不会生效! 10 秒一到,不管你业务有没有执行完,锁直接释放。
lock.lock() (无参方法)
- 底层逻辑:默认传入的 leaseTime 是 -1
- 触发看门狗:Redisson 发现你没传时间,就会使用默认的看门狗时间 getLockWatchdogTimeout()(默认是 30 秒)来加锁。并且在加锁成功后,偷偷开启一个后台续命线程。
抢锁失败后的逻辑
- 不会像纯 while(true) 那样疯狂空转消耗 CPU。
- 利用 Redis 的 Pub/Sub(发布/订阅)机制,订阅这把锁释放的消息。
- 利用 Semaphore(信号量)将当前线程阻塞挂起。阻塞的最大时间就是刚查出来的 ttl 时间。
- 一旦收到别人释放锁的消息,或者等到了 ttl 时间,线程被唤醒,再进入 while(true) 循环重新去尝试抢锁。
- (这种“订阅 + 阻塞挂起 + 唤醒重试”的机制,既保证了抢锁的及时性,又极大减轻了 CPU 和 Redis 的压力。
抢锁成功呢,看门狗机制又是如何发挥作用实现自动延期的呢。
- 如果你调用了无参的 lock() 并且成功拿到了锁(ttlRemaining == null)
- scheduleExpirationRenewal(threadId) 方法就会被调用,这就是看门狗的启动开关。
RFuture<Long> ttlRemainingFuture = tryLockInnerAsync(waitTime, commandExecutor.getConnectionManager().getCfg().getLockWatchdogTimeout(), TimeUnit.MILLISECONDS, threadId, RedisCommands.EVAL_LONG);ttlRemainingFuture.onComplete((ttlRemaining, e) -> { if (e != null) { return; } // lock acquired if (ttlRemaining == null) { scheduleExpirationRenewal(threadId); }});return ttlRemainingFuture;第一步:设定定时任务(TimerTask)
- Redisson 底层并没有用传统的线程池死循环
- 使用 Netty 的 HashedWheelTimer(时间轮)实现了一个轻量级的延时任务 Timeout task。
- 它会告诉你:“等一段时间后,去执行续约逻辑”。
第二步:什么时候去续约?(10秒法则)
- 看门狗默认的超时时间(WatchdogTimeout)是 30 秒。
- Redisson 内部硬编码了一个规则:每隔 WatchdogTimeout / 3 的时间去执行一次续约。
- 只要锁还在,每隔 10 秒钟,看门狗就会苏醒一次。 第三步:怎么续约?(递归调用与 Lua 脚本)
private void renewExpiration() { ExpirationEntry ee = EXPIRATION_RENEWAL_MAP.get(getEntryName()); if (ee == null) { return; }
Timeout task = commandExecutor.getConnectionManager().newTimeout(new TimerTask() { @Override public void run(Timeout timeout) throws Exception { ExpirationEntry ent = EXPIRATION_RENEWAL_MAP.get(getEntryName()); if (ent == null) { return; } Long threadId = ent.getFirstThreadId(); if (threadId == null) { return; }
RFuture<Boolean> future = renewExpirationAsync(threadId); future.onComplete((res, e) -> { if (e != null) { log.error("Can't update lock " + getName() + " expiration", e); return; }
if (res) { // 续期的主要方法 renewExpiration(); } }); } }, internalLockLeaseTime / 3, TimeUnit.MILLISECONDS);
ee.setTimeout(task);}- 当 10 秒倒计时结束,执行 renewExpiration() 内部的代码:
- 发 Lua 脚本给 Redis:判断当前这把锁是不是还是当前线程持有。
- 刷新 TTL:如果还是自己持有,就执行 pexpire 命令,把这把锁的存活时间重新重置回 30 秒!
- 无限循环(递归):续期成功后,调用自己(递归),重新安排下一个 10 秒后的定时任务。
如果服务器宕机了,看门狗会无限续期导致死锁吗?
- 不会,看门狗的 TimerTask 是运行在当前 JVM 进程内存中的延时任务。如果服务器突然断电宕机,或者 JVM 进程被杀掉,看门狗线程也会瞬间死亡。
- 最终结果:由于没有人再去周期性地调用 renewExpiration() 发送续约命令,Redis 中的那把锁会在度过它生命中最后的 30 秒后,自然过期释放。其他服务器上的线程就能重新抢到这把锁。
- Redisson 设计的精妙之处:用 JVM 内部的生命周期,去兜底分布式环境的容错性
原理
- Redisson 使用 Redis Hash 保存锁。定义个Value记录可重试次数
- 在实现可重入性这块也借鉴了ReentrantLock的方式。
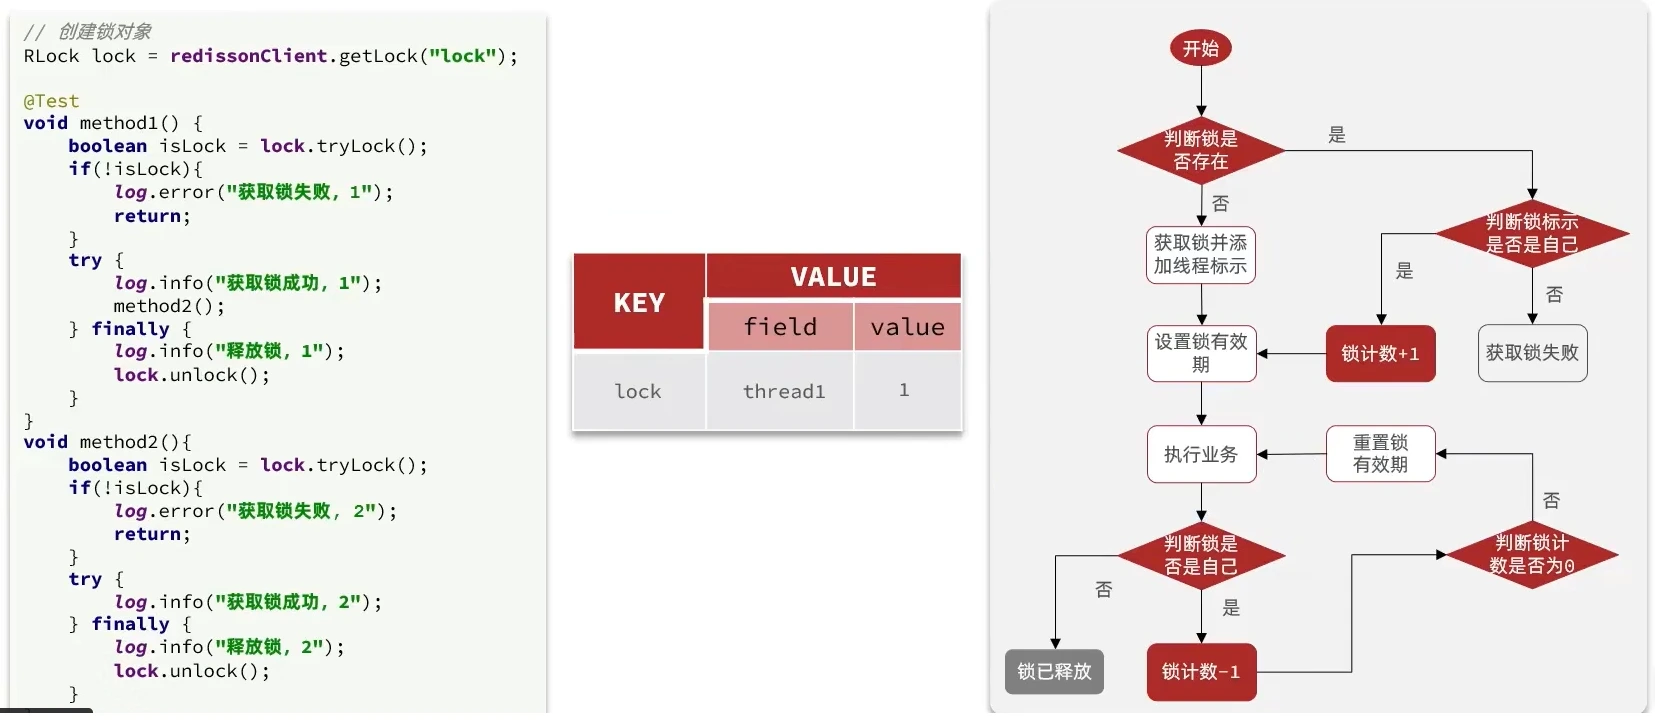
ReentrantLock可重入锁的实现方式
if (compareAndSetState(0, 1)) { setExclusiveOwnerThread(current); return true;} else if (getExclusiveOwnerThread() == current) { setState(getState() + 1); // 重入计数 return true;}Lock核心原理、
-
底层的一个voaltile的一个state变量来记录重入的状态
-
内部维护一个 state 计数器(int 类型)记录锁的持有次数。
-
首次获取锁:state 从 0 通过 CAS 设置为 1,并记录当前线程为 exclusiveOwnerThread。
-
重入获取锁:如果当前线程已是锁的持有者,直接将 state++,无需进入等待队列。
-
释放锁:state—,当 state 归零时清空持有线程并唤醒等待队列中的线程
Hash 结构拆解为三层含义:
-
KEY(大 Key):锁的名字,比如叫 lock,锁是否存在
-
FIELD(小 Key):持有这把锁的线程标识。这把锁被哪个线程持有
-
VALUE(值):重入的次数(count)。一开始是 1,重入一次变 2,释放一次变 1,直到减为 0 时删除这把锁。
Redission为了保证查看锁是否存在和获取锁两个动作的原子性,依旧使用了Lua脚本。
-
明确脚本调用时传入的三个参数:
-
KEYS[1]:锁的名字(例如 “myLock”)。
-
ARGV[1]:锁的过期时间(例如 30000 毫秒)。
-
ARGV[2]:当前请求的线程标识(UUID
if (redis.call('exists', KEYS[1]) == 0) then //判断锁存在,如果==0,就表示当前这把锁不存在 redis.call('hset', KEYS[1], ARGV[2], 1); //判断同一线程再次请求锁 redis.call('pexpire', KEYS[1], ARGV[1]); return nil;end;
if (redis.call('hexists', KEYS[1], ARGV[2]) == 1) then//同一线程再次请求锁**(可重入场景)将重入次数+1 redis.call('hincrby', KEYS[1], ARGV[2], 1); redis.call('pexpire', KEYS[1], ARGV[1]); return nil;end;
return redis.call('pttl', KEYS[1]);分支1
判断当前这把锁是否存在
- 用 hset 创建一个 Hash,记录下当前线程 ARGV[2],并将重入次数设为 1。接着给这把锁设置过期时间 ARGV[1] 以防死锁。
分支2
判断当前这把锁是否是属于当前线程
-
如果锁存在而且是自己的,那就说明是重入操作。调用 hincrby 把 value 的值加 1(比如从 1 变成 2)。
-
因为我又加了一把锁,我要重新刷新一下锁的过期时间(续期)
-
返回
nil代表抢锁成功。
分支3
上面两个 if 都没进去,说明锁被别人占了。调用 pttl 命令,查看这把锁离过期还有多少毫秒。将剩余存活时间返回给 Java 客户端。
- 抢锁过程中,获得当前线程,通过tryAcquire进行抢锁
- 分支1,2都不满足,进入第三个条件,返回的是锁的失效时间,while( true) 再次进行tryAcquire进行抢锁,
如果 Lua 脚本返回了 nil,Java 代码就知道自己拿到锁了,直接往下执行业务。
- 那如果返回的不是 nil(而是锁的剩余时间 pttl)呢? Redisson 底层并没有直接报错放弃,而利用了返回的那个 pttl 时间:
- Java 客户端会利用 Semaphore(信号量)或者基于 Redis 的 Pub/Sub(发布订阅机制)进行阻塞等待。
- 等待的时间就是刚才返回的 pttl(人家还有多久释放,我就等多久,不盲目消耗 CPU)。
- 等别人释放锁后,被唤醒,触发一个 while(true) 的循环,重新再去执行上面的 Lua 脚本抢锁。
- 释放锁的逻辑与获取锁的逻辑十分相似,只不过倒了过来。
当执行 lock.unlock() 时,同样会发送一段 Lua 脚本:
- 先判断当前持有锁的是不是自己。如果不是,直接抛异常(你不能释放别人的锁)。
- 如果是自己,执行 hincrby -1(把重入次数减 1)。
- 关键判断:减去 1 之后,如果重入次数 > 0,说明外层方法还需要这把锁,此时不能删除大 Key,仅仅是重置一下过期时间。
- 减去 1 之后,如果重入次数 == 0,说明是最外层的方法要退出了,此时直接执行 del KEYS[1],彻底释放分布式锁,并通过发布订阅机制通知其他正在等锁的线程。
可重入锁
MutiLock
为了提高redis的可用性,我们会搭建集群或者主从
- 写命令到主机上, 主机会将数据同步给从机,
- 假设在主机还没有来得及把数据写入到从机去的时候
- 此时主机宕机,哨兵会发现主机宕机,并且选举一个slave变成master,而此时新的master中实际上并没有锁信息,此时锁信息就已经丢掉了
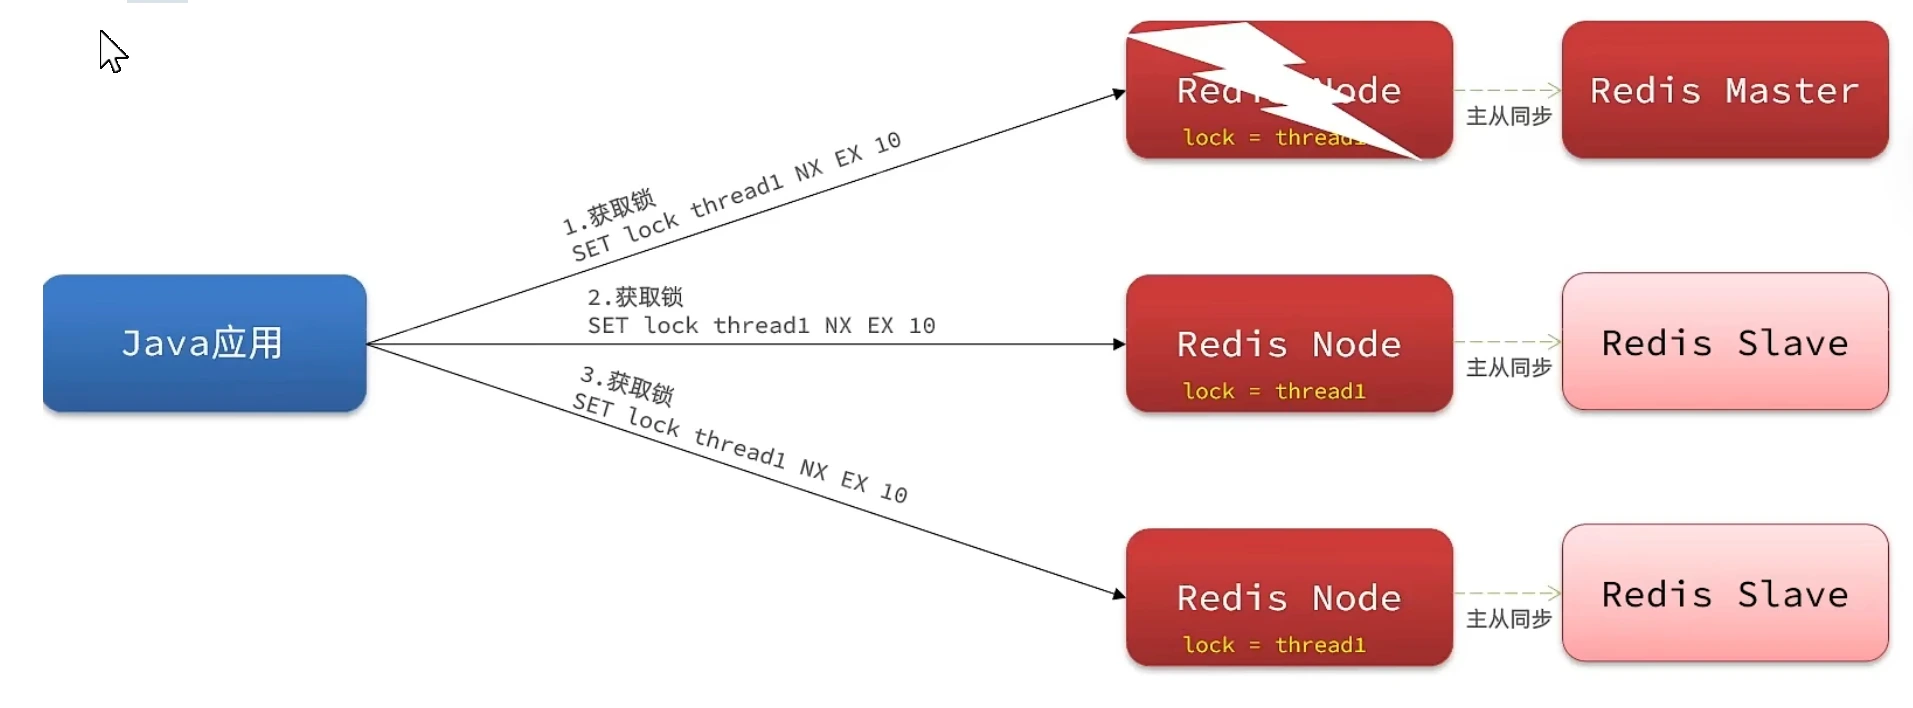
- 使用这把锁不使用主从了,每个节点的地位都是一样的, 这把锁加锁的逻辑需要写入到每一个主丛节点上,
- 只有所有的服务器都写入成功,此时才是加锁成功,假设现在某个节点挂了,那么他去获得锁的时候,
- 只要有一个节点拿不到,都不能算是加锁成功,就保证了加锁的可靠性。
原理
- 设置了多个锁时,redission会将多个锁添加到一个集合中
- 用while循环去不停去尝试拿锁,但是会有一个总共的加锁时间,这个时间是用需要加锁的个数 * 1500ms ,
- 假设有3个锁,那么时间就是4500ms,假设在这4500ms内,所有的锁都加锁成功, 那么此时才算是加锁成功,
- 如果在4500ms有线程加锁失败,则会再次去进行重试.
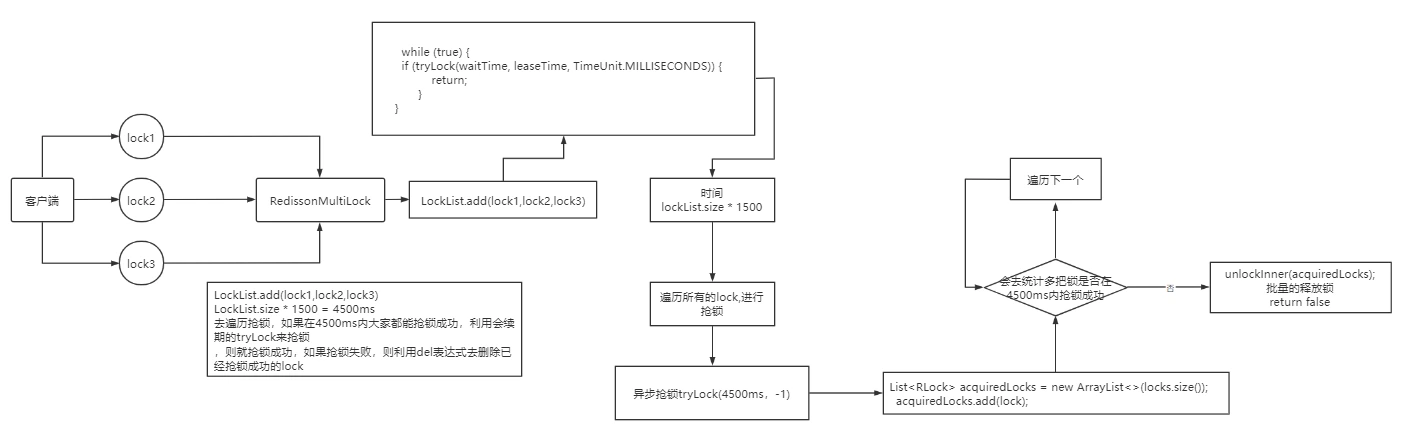
| 特性 | Redis SETNX | Redisson | Zookeeper |
|---|---|---|---|
| 性能 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐ |
| 可靠性 | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| 实现复杂度 | ⭐⭐ | ⭐ | ⭐⭐⭐⭐ |
| 自动续期 | ❌ | ✅ | ✅ |
| 可重入 | ❌ | ✅ | ✅ |
| 适用场景 | 简单场景 | ✅ 生产推荐 | 强一致性 |
Redis持久化
RDB
fork()创建子进程共享内存数据(内存快照),遍历写入dump.rdb存入磁盘中,写完通知主进程新文件替换旧文件
| 方案 | 原理 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| RDB | 定时快照 | 文件小,恢复快 | 数据丢失风险 | 可容忍少量数据丢失 |
| AOF | 追加日志 | 数据完整性好 | 文件大,恢复慢 | ✅ 推荐 |
| 混合持久化 | RDB + AOF | 兼顾两者优点 | Redis 4.0+ | ✅ 生产推荐 |
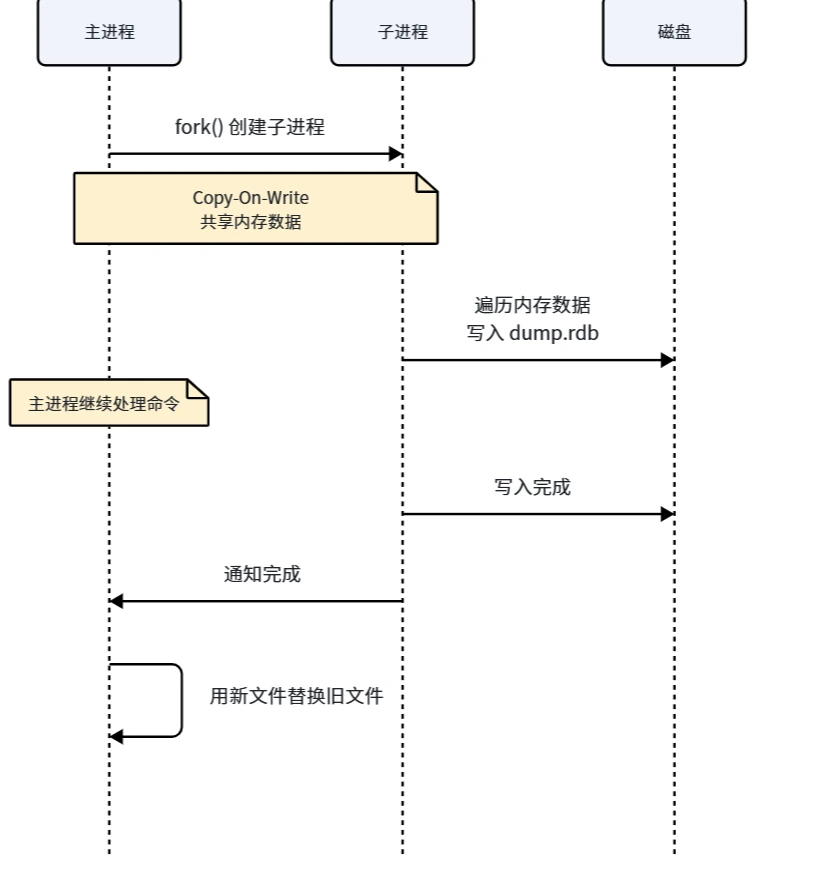
# 自动触发条件save 900 1 # 900秒内至少1次修改save 300 10 # 300秒内至少10次修改save 60 10000 # 60秒内至少10000次修改
# RDB文件名dbfilename dump.rdb
# 存储目录dir /var/lib/redis
# 压缩rdbcompression yes
# 校验rdbchecksum yes# 同步保存(阻塞)SAVE
# 异步保存(非阻塞)BGSAVEAOF
Redis执行命令写入AOF缓冲区,利用三种刷盘方法,推荐每秒刷盘一次
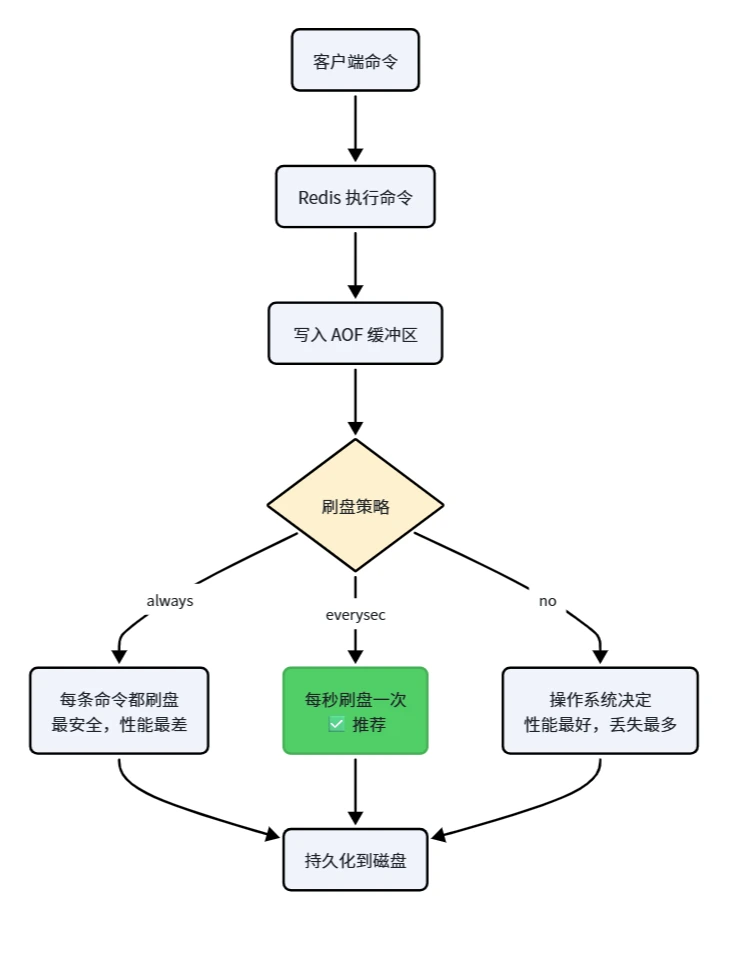
# 启用 AOFappendonly yes
# AOF 文件名appendfilename "appendonly.aof"
# 刷盘策略(推荐 everysec)appendfsync everysec# appendfsync always# appendfsync no
# AOF 重写auto-aof-rewrite-percentage 100 # 文件大小增长100%触发重写auto-aof-rewrite-min-size 64mb # 文件至少64MB才重写AOF重写
fork子进程(内存快照)重新生成命令,新命令保留在AOF缓冲区,子进程完工追加并切换为新的AOF
# 原始命令SET key1 value1SET key1 value2SET key1 value3DEL key2SET key2 valueAINCR counterINCR counterINCR counter# 合并为最终状态SET key1 value3SET key2 valueASET counter 3触发方式
# 手动触发BGREWRITEAOF
# 自动触发(配置文件)auto-aof-rewrite-percentage 100auto-aof-rewrite-min-size 64mb| 对比项 | RDB 后台保存(BGSAVE) | AOF 后台重写(BGREWRITEAOF) |
|---|---|---|
是否使用 fork | 是,创建子进程 | 是,创建子进程 |
fork 后的内存机制 | 写时复制(COW):父子进程起初共享内存页,发生写入时才复制相关页 | 同左 |
| 子进程看到的数据 | fork 时刻的数据快照 | fork 时刻的数据快照 |
| 子进程主要工作 | 遍历数据,生成 RDB 快照文件 | 根据当前数据状态,生成更精简的 AOF 基础文件 |
| 父进程如何处理新请求 | 继续处理业务请求;启用 AOF 时,也继续记录 AOF | 继续处理业务请求,并记录重写期间产生的增量写入 |
| 重写期间的增量数据 | 不会写入本次 RDB 快照;留待后续持久化 | 必须保留重写缓冲区,子进程完成追加 |
| 子进程完成后 | 用新 RDB 文件替换原 RDB 文件 | 将新的基础内容与重写期间的增量内容衔接,再切换到新 AOF |
| 产出内容 | 某一时刻的数据快照 | 能重建数据的精简内容,去掉旧 AOF 中大量冗余操作 |
| 主要目的 | 生成数据快照,便于备份和恢复 | 缩小持续追加后不断增长的 AOF |
| 是否阻塞主线程 | fork 阶段会短暂阻塞;子进程生成文件期间主线程通常继续工作 | 同左;完成时还可能有短暂的切换工作 |
混合持久化
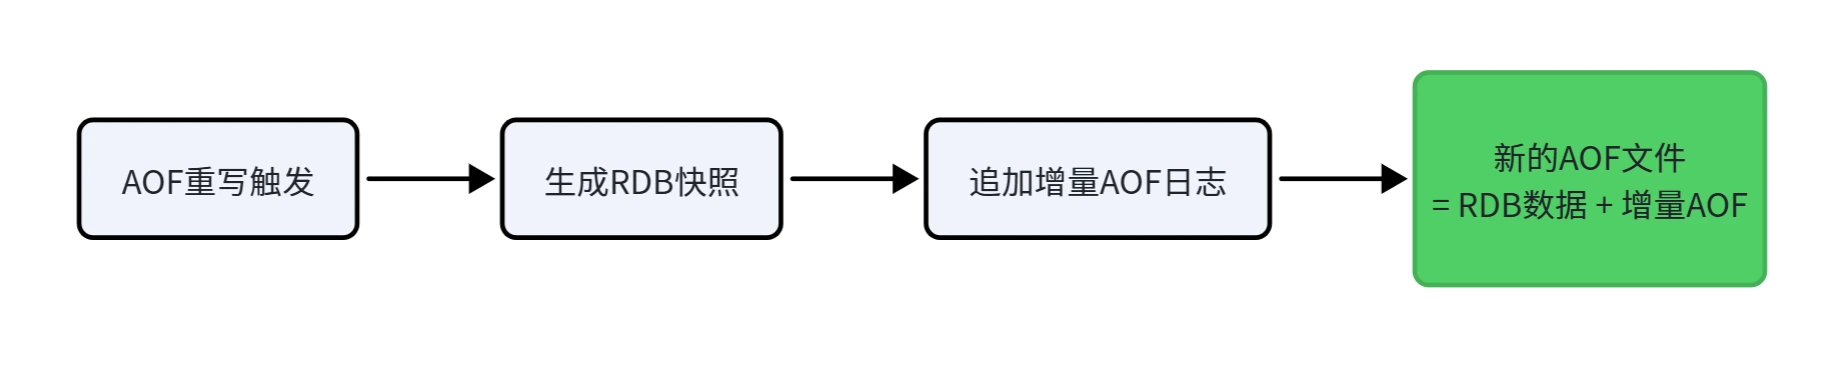
# 启用混合持久化aof-use-rdb-preamble yes| 对比项 | RDB(BGSAVE) | AOF(正常追加) | AOF 重写(BGREWRITEAOF) | 混合持久化(aof-use-rdb-preamble yes) |
|---|---|---|---|---|
| 核心思路 | 保存某一时刻的数据快照 | 持续记录会改变数据的命令 | 根据当前数据生成更精简的 AOF 基础内容,清理冗余历史 | AOF 重写生成的基础内容使用 RDB 格式,后续仍记录 AOF 增量 |
| 触发方式 | 手动执行 BGSAVE,或由 save 规则触发 | 开启 AOF 后,随写操作持续进行 | 手动执行 BGREWRITEAOF,或达到自动重写条件 | 配置开启后,在 AOF 重写时生效 |
是否 fork 子进程 | 是,利用写时复制(COW) | 正常追加本身不需要 fork | 是,利用 COW | 是,沿用 AOF 重写流程 |
| 子进程做什么 | 遍历 fork 时看到的数据,生成 RDB 文件 | 无重写子进程;写操作进入 AOF 缓冲区,再按策略刷盘 | 遍历 fork 时看到的数据,生成可重建数据的精简基础内容;不一定都是 SET 命令 | 将 fork 时看到的数据写成 RDB 格式的 AOF 基础内容 |
fork 后的新写入 | 不进入本次 RDB 快照 | 持续记录到 AOF | 必须另外保留增量,最终与新的基础内容衔接 | 同 AOF 重写;增量以 AOF 命令形式保留 |
| 是否有“重写缓冲区” | 没有 | 正常追加不使用重写缓冲区 | Redis 6 及更早版本有;Redis 7 改用多文件 AOF 的增量文件机制 | 跟随对应版本的 AOF 重写机制 |
| 文件内容 | RDB 二进制快照 | AOF 命令记录,可能积累冗余操作;并非严格意义上的纯文本 | 精简后的 AOF 基础内容,具体格式取决于配置和版本 | RDB 格式的基础内容 + AOF 格式的增量内容;Redis 7 中可能分布在多个文件里 |
| 宕机丢失数据 | 可能丢失最近一次快照之后的写入 | 主要取决于 appendfsync:always 风险较低;everysec 通常可能丢约 1 秒;no 风险更高 | 重写本身不决定丢失窗口,仍取决于 AOF 刷盘策略 | 仍取决于 AOF 刷盘策略;不能仅凭“混合”保证最多丢 1 秒 |
| 重启时如何恢复 | 直接加载 RDB 快照 | 加载 AOF 内容以重建数据 | 重写完成后,按新的 AOF 文件结构加载;重写不是单独的恢复方式 | 先加载 RDB 格式的基础内容,再回放 AOF 增量 |
| 恢复速度 | 通常较快 | 命令多时可能较慢 | 冗余减少后,通常比重写前更快 | 通常较快,但仍受增量 AOF 长度影响 |
| 主要代价 | 快照间隔可能造成数据丢失;fork 和 COW 会带来开销 | 文件可能膨胀;刷盘产生 I/O 压力 | fork 可能短暂阻塞,重写消耗 CPU、内存和磁盘 I/O | 文件结构较复杂,不能把整个 AOF 都当作可读命令查看 |
| 常见用途 | 定期快照、备份、加快全量恢复 | 持续记录写入,提高持久化能力 | 控制 AOF 文件体积 | 在使用 AOF 的同时,提高基础数据的加载效率 |
优点:
-
恢复速度快(RDB 部分)
-
数据完整性好(AOF 增量)
-
文件相对较小
主从复制
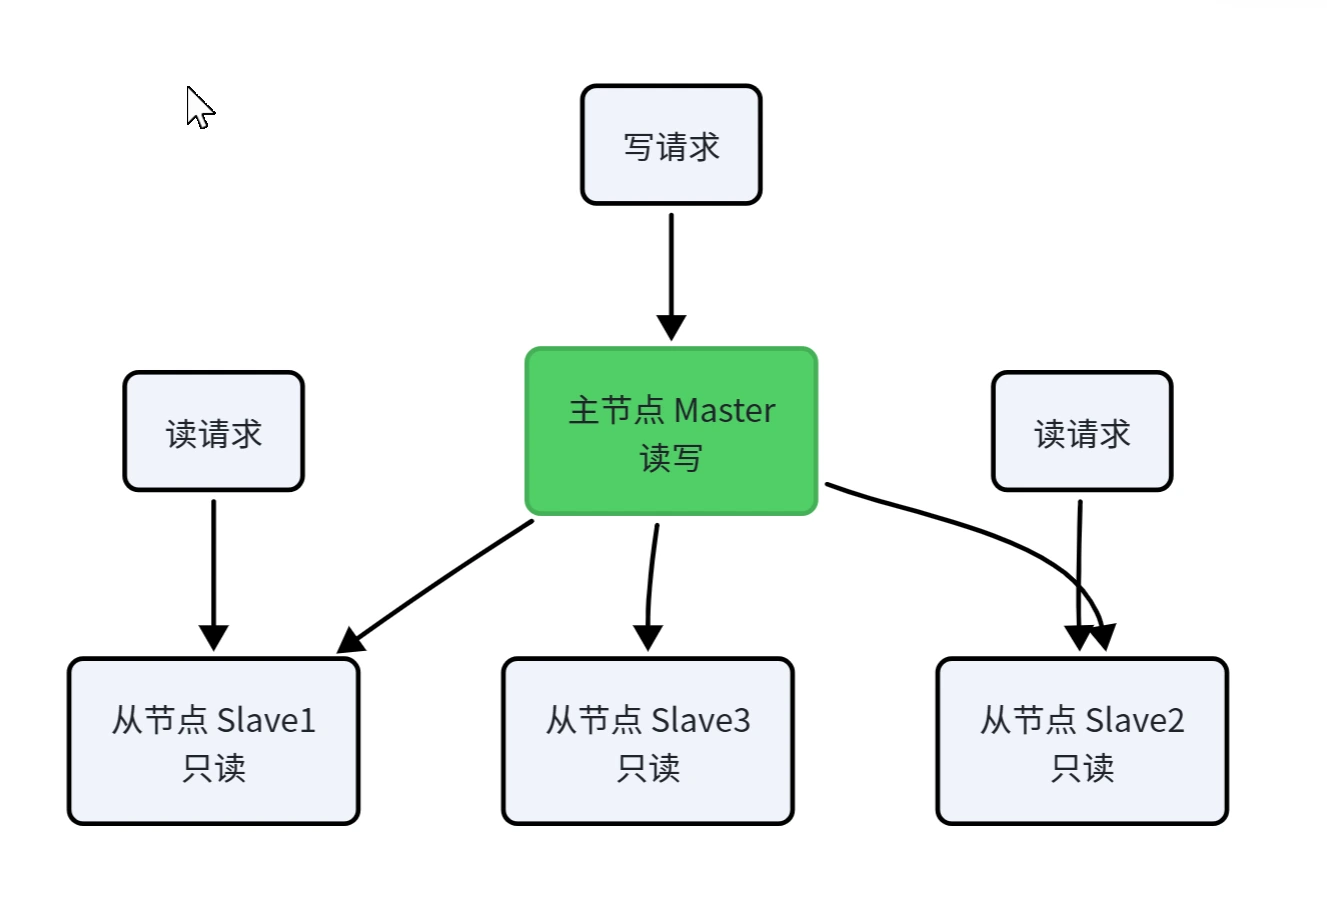
# 从节点配置replicaof 192.168.1.100 6379 # 主节点IP和端口masterauth your_password # 主节点密码哨兵模式
作用:监控主从节点,自动故障转移
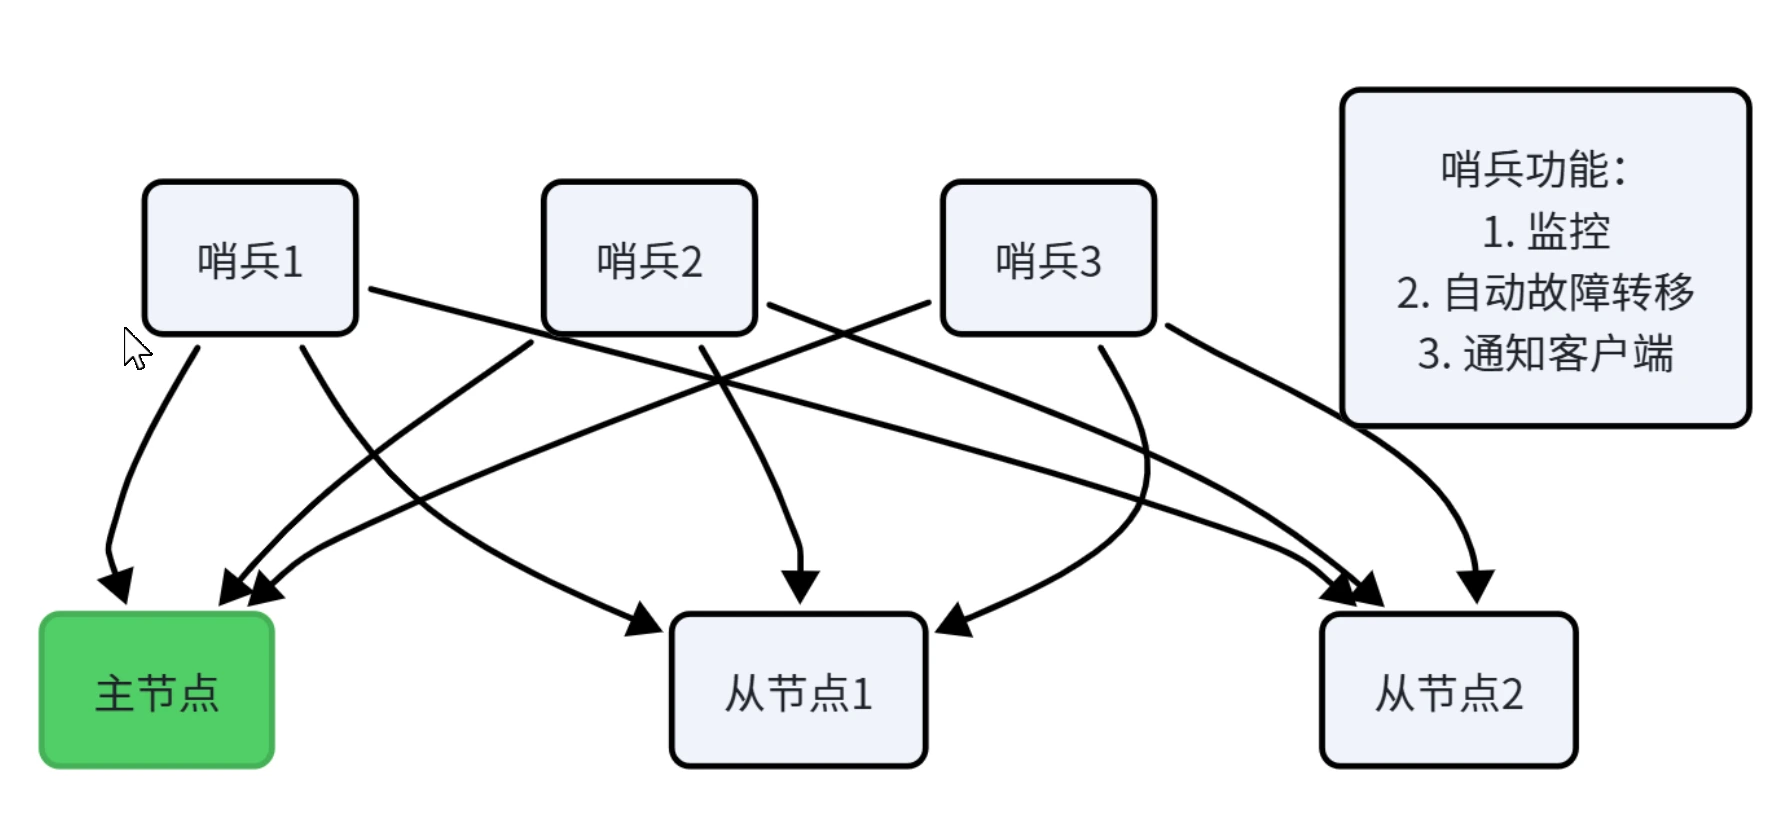
# 监控主节点sentinel monitor mymaster 192.168.1.100 6379 2
# 2个哨兵认为主节点下线,才判定为客观下线
# 主节点密码sentinel auth-pass mymaster your_password
# 判定下线时间(毫秒)sentinel down-after-milliseconds mymaster 30000
# 故障转移超时sentinel failover-timeout mymaster 180000
# 同时同步的从节点数量sentinel parallel-syncs mymaster 1启动哨兵
redis-sentinel /path/to/sentinel.conf集群模式
特点:数据分片 + 高可用
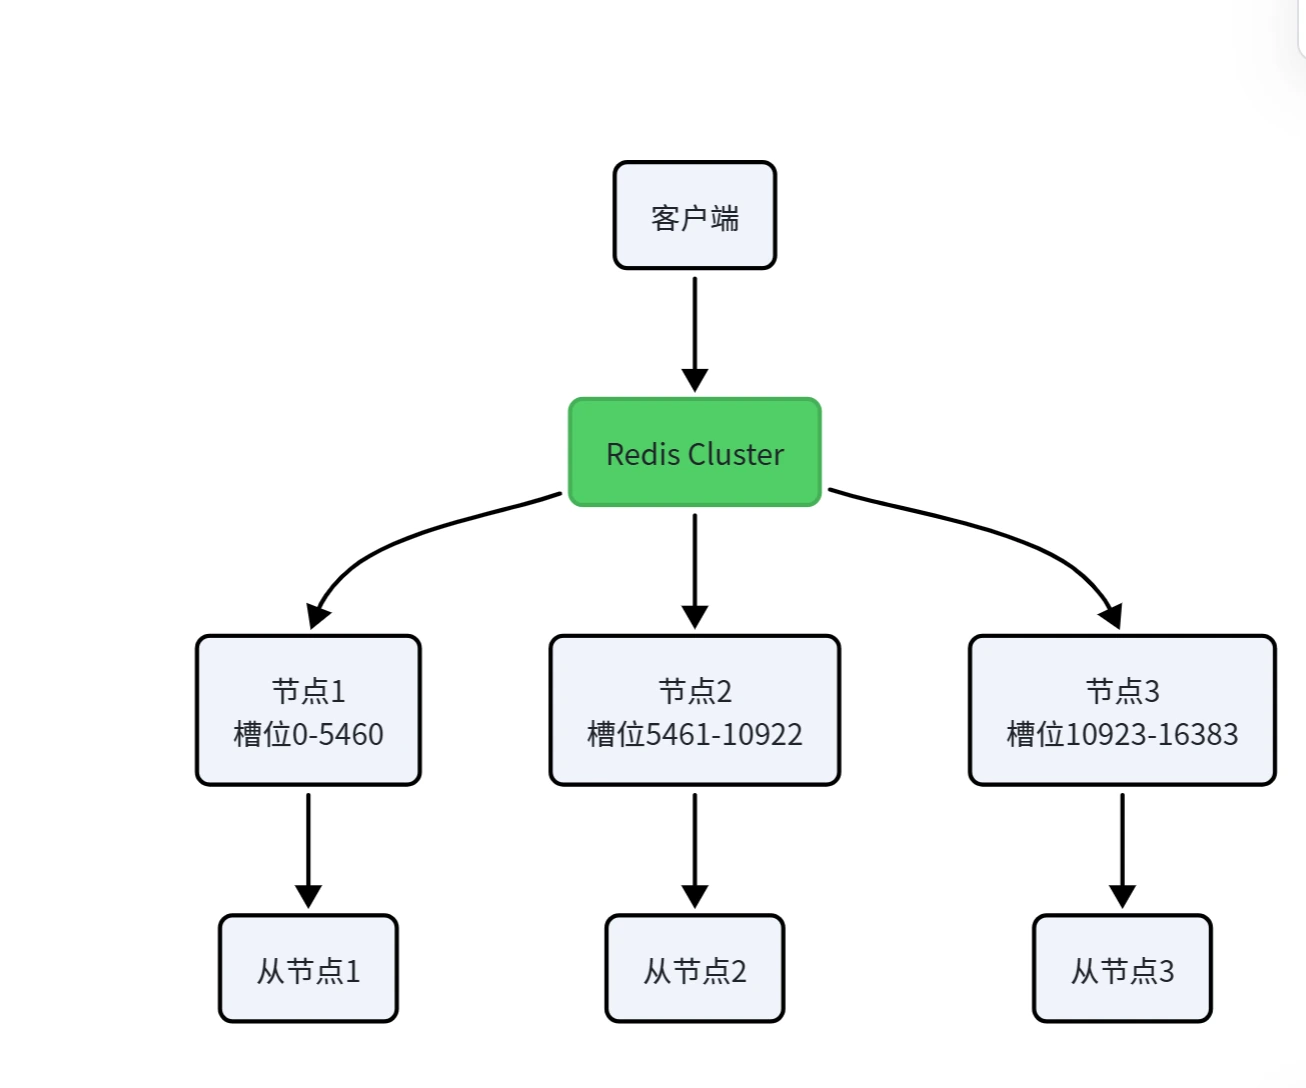
# 启用集群模式cluster-enabled yes
# 集群配置文件cluster-config-file nodes-6379.conf
# 节点超时时间cluster-node-timeout 15000事务
一次性执行多条命令
- multi<开启一个事务>,multi执行之后,客户端可以继续向服务器发送任意多条命令,这些命令不会立即被执行,而是被放到一个队列中。
- exec:执行队列中所有的命令
- discard<中断当前事务>,然后清空事务队列并放弃执行事务
- watch keyl key2·监视一个(或多个)key如果在事务执行之前这个(或这些)key被其他命令所改动,那么事务将被打断。
- 在watch监控后,有人修改了balance,会导致事务会被打断,必须更新最新值,才能成功执行事以于乐观锁的版本号机制。
- 如果某条命令逻辑出错会部分会回滚
事务的三个阶段
- 开启:以multi开始一个事务
- 入队:将多个命令入队到事务中,接到这些命令并不会立即执行,而是放到等待执行的事务队列里面
- 执行:由exec命令触发事务
性能优化
慢查询
某条命令在 Redis 服务器内部执行的时间超过了设定阈值Redis 就把它记到慢查询日志(Slow Log)里。
配置慢查询
# 慢查询阈值(微秒)slowlog-log-slower-than 10000 # 10毫秒
# 慢查询日志最大长度slowlog-max-len 128# 查看最近的慢查询SLOWLOG GET 10
# 查看慢查询数量SLOWLOG LEN
# 清空慢查询日志SLOWLOG RESETSCAN命令
// ❌ 错误:KEYS 命令会阻塞 RedisSet<String> keys = redisTemplate.keys("user:*");
// ✅ 正确:使用 SCAN 命令ScanOptions options = ScanOptions.scanOptions() .match("user:*") .count(100) .build();
Cursor<String> cursor = redisTemplate.scan(options);while (cursor.hasNext()) { String key = cursor.next(); // 处理key}SCAN 命令优点:
-
渐进式遍历,不阻塞
-
返回游标,支持分批获取
-
生产环境必备
大Key
拆分
查询大key
# Redis 自带工具redis-cli --bigkeys
# 扫描结果示例[00.00%] Biggest string found so far '"user:10001"' with 512000 bytes[00.00%] Biggest list found so far '"queue:task"' with 50000 items[00.00%] Biggest hash found so far '"goods:1001"' with 10000 fields优化方案
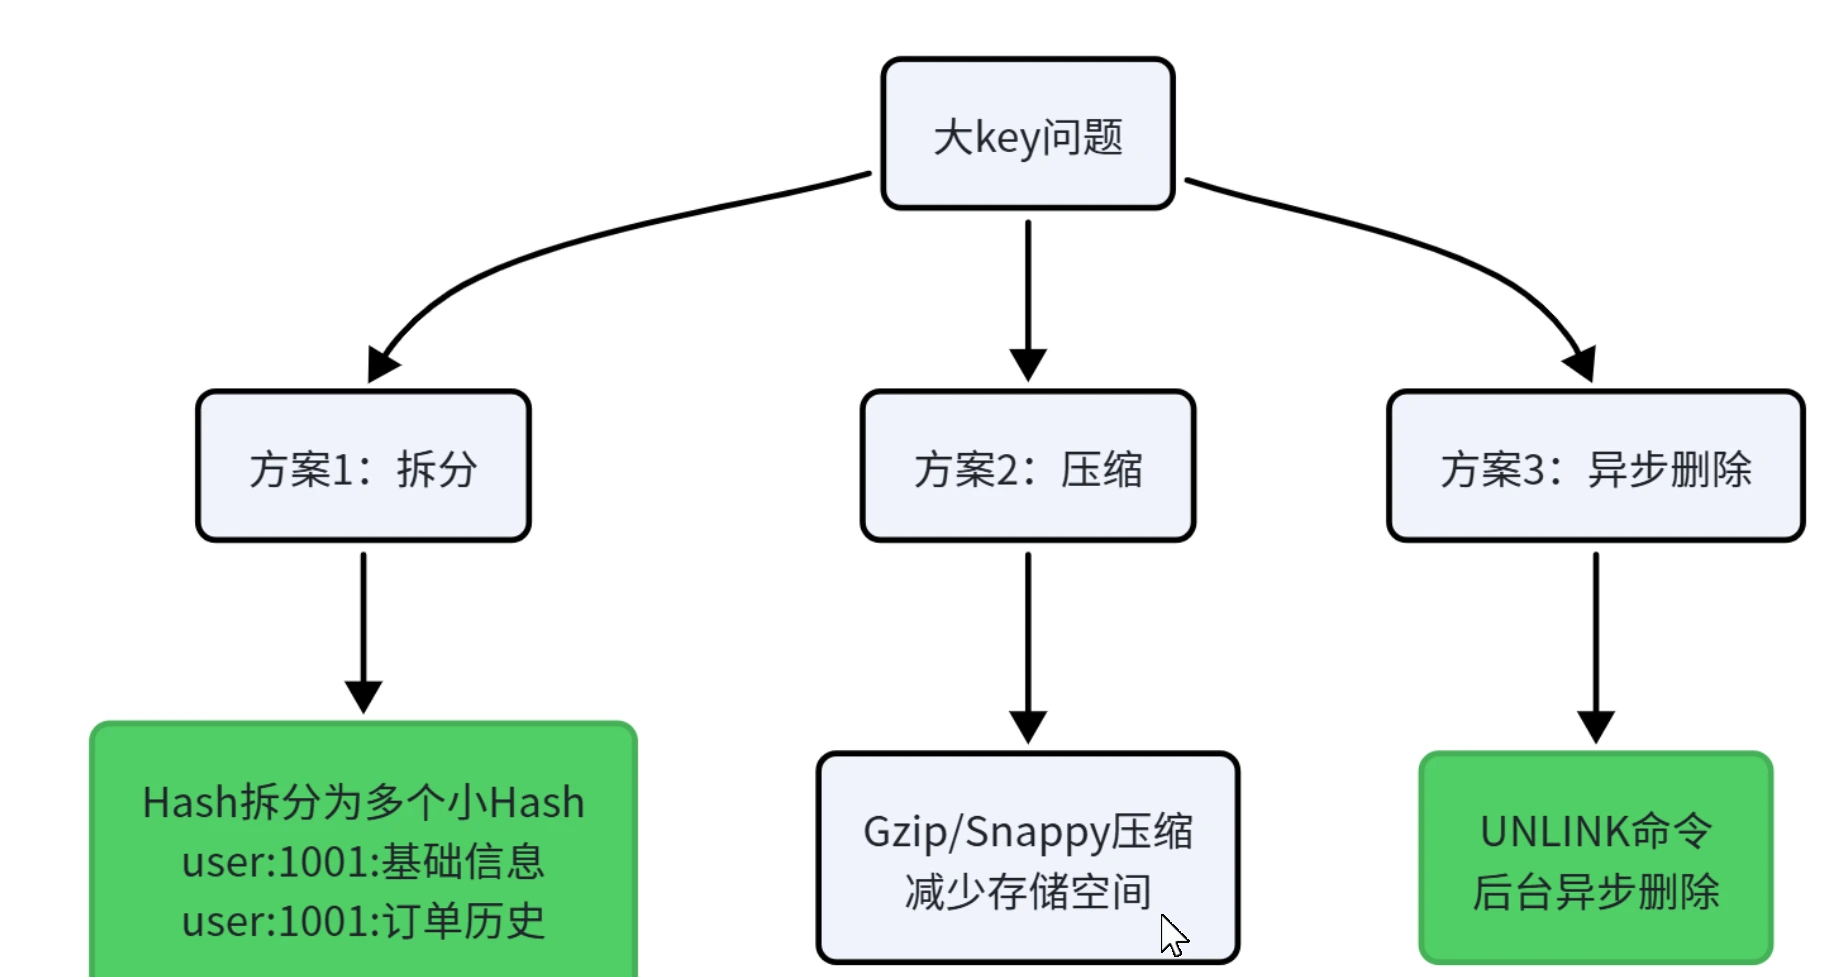
///拆分为多个Hashpublic void cacheUser(User user) { // 基础信息 Map<String, String> basicInfo = new HashMap<>(); basicInfo.put("name", user.getName()); basicInfo.put("age", String.valueOf(user.getAge())); redisTemplate.opsForHash().putAll("user:1001:basic", basicInfo);
// 订单历史(分页存储) List<Order> orders = user.getOrders(); for (int i = 0; i < orders.size(); i += 100) { int page = i / 100; List<Order> pageOrders = orders.subList(i, Math.min(i + 100, orders.size())); redisTemplate.opsForValue().set( "user:1001:orders:" + page, JSON.toJSONString(pageOrders) ); }}异步删除
# Redis 4.0+UNLINK big_key # 异步删除,不阻塞
# 对比DEL big_key # 同步删除,可能阻塞几秒 Java 中使用 UNLINKredisTemplate.unlink("big_key");热Key
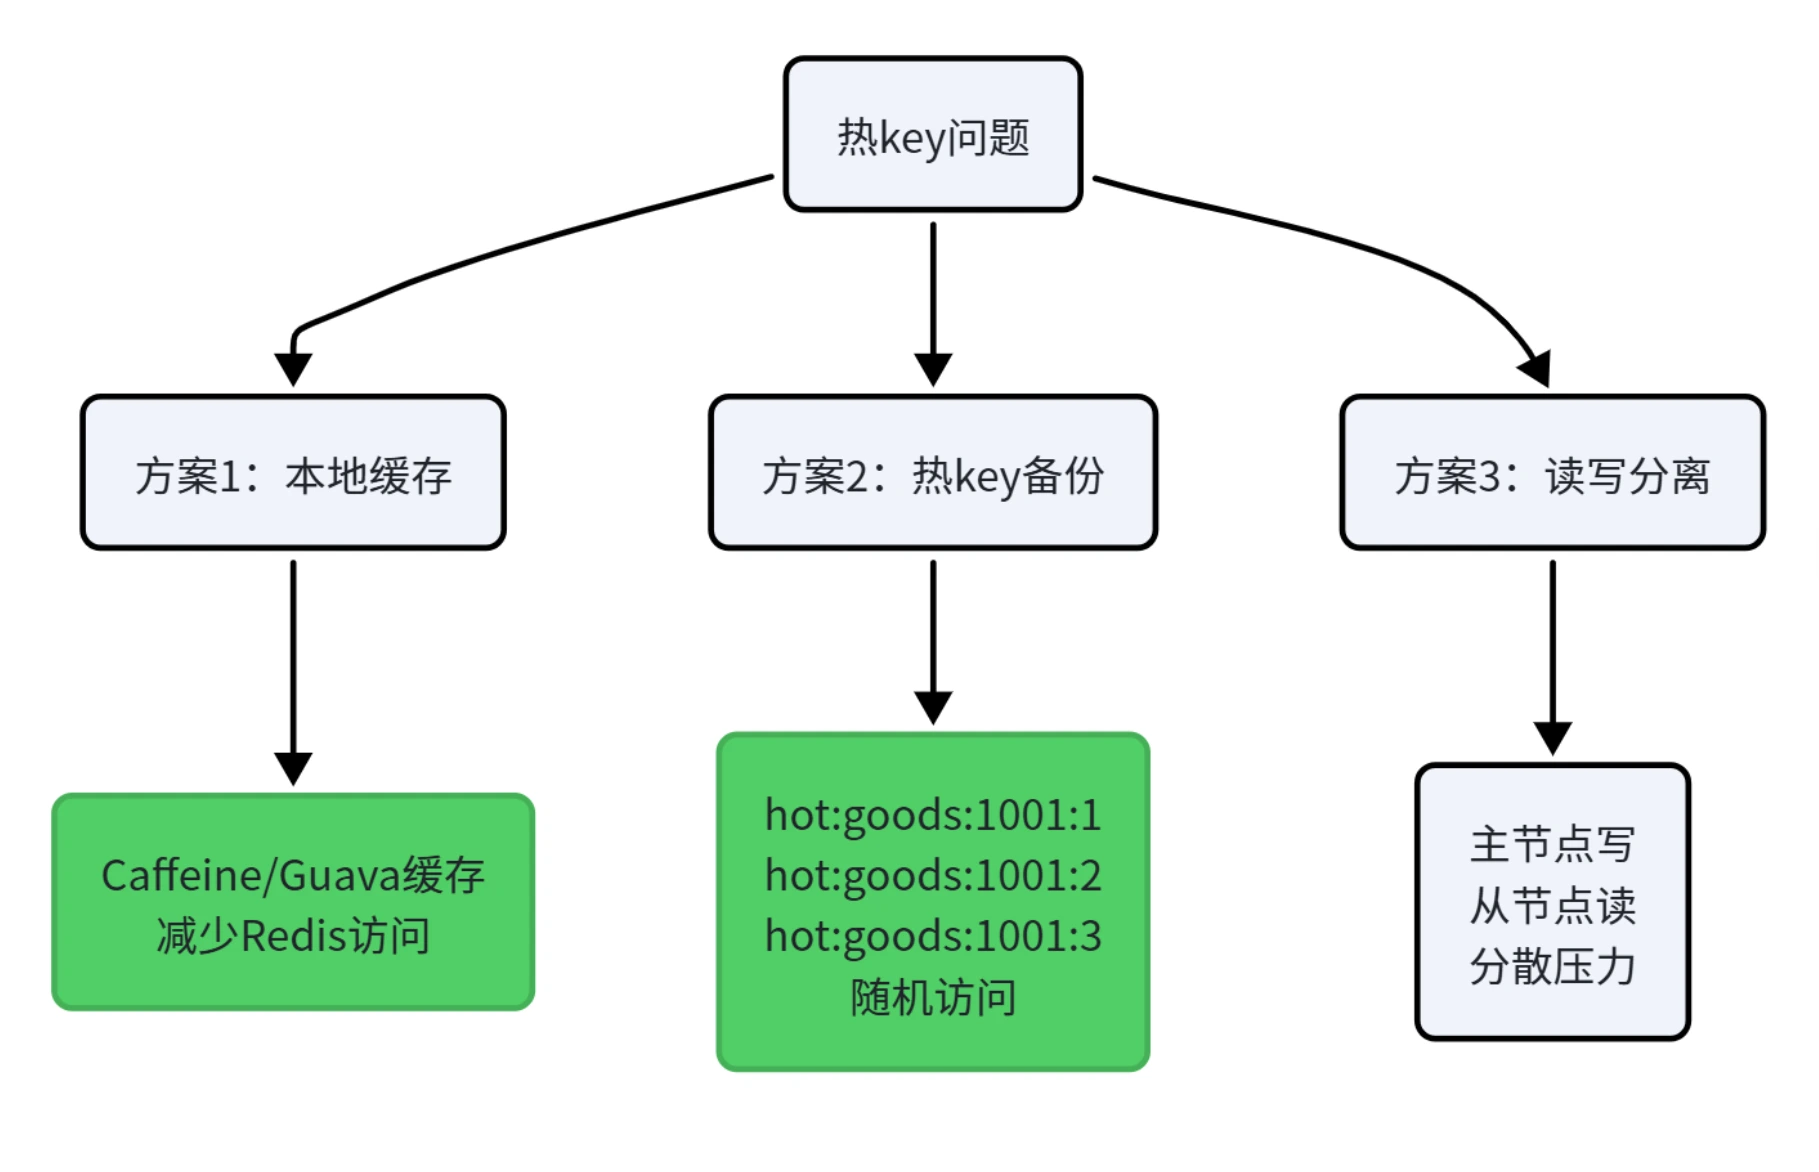
本地缓存
@Configurationpublic class HotKeyCacheConfig { @Bean public Cache<String, String> hotKeyCache() { return Caffeine.newBuilder() .maximumSize(1000) // 最多1000个热key .expireAfterWrite(1, TimeUnit.MINUTES) // 1分钟过期 .build(); }}
@Servicepublic class GoodsService { @Autowired private Cache<String, String> hotKeyCache;
@Autowired private StringRedisTemplate redisTemplate;
public Goods getHotGoods(Long goodsId) { String cacheKey = "goods:" + goodsId;
// 1. 查本地缓存 String json = hotKeyCache.getIfPresent(cacheKey); if (json != null) { return JSON.parseObject(json, Goods.class); }
// 2. 查 Redis json = redisTemplate.opsForValue().get(cacheKey); if (json != null) { // 写入本地缓存 hotKeyCache.put(cacheKey, json); return JSON.parseObject(json, Goods.class); }
// 3. 查数据库... return null; }}备份
public Goods getHotGoods(Long goodsId) { // 随机选择一个备份key(1-10) int replica = ThreadLocalRandom.current().nextInt(1, 11); String cacheKey = "hot:goods:" + goodsId + ":" + replica;
String json = redisTemplate.opsForValue().get(cacheKey); if (json != null) { return JSON.parseObject(json, Goods.class); }
// 未命中,查数据库并写入所有备份 Goods goods = goodsMapper.selectById(goodsId); if (goods != null) { String goodsJson = JSON.toJSONString(goods);
// 写入10个备份 for (int i = 1; i <= 10; i++) { String key = "hot:goods:" + goodsId + ":" + i; redisTemplate.opsForValue().set(key, goodsJson, 5, TimeUnit.MINUTES); } }
return goods;}内存优化
内存淘汰
设置淘汰规则
# 最大内存maxmemory 2gb
# 淘汰策略maxmemory-policy allkeys-lru| 策略 | 说明 | 适用场景 |
|---|---|---|
| noeviction | 不淘汰,内存满时报错 | 不推荐 |
| allkeys-lru | 从所有key中淘汰最少使用的 | ✅ 通用推荐 |
| allkeys-lfu | 从所有key中淘汰访问频率最低的 | Redis 4.0+ |
| volatile-lru | 从设置了过期时间的key中淘汰 | 部分key需要持久化 |
| volatile-ttl | 淘汰即将过期的key | 优先淘汰快过期的 |
| allkeys-random | 随机淘汰 | 测试环境 |
碎片化
自动碎片整理
启用自动碎片整理activedefrag yes
# 碎片率达到100%时触发active-defrag-ignore-bytes 100mbactive-defrag-threshold-lower 10active-defrag-threshold-upper 100
# CPU占用限制active-defrag-cycle-min 5active-defrag-cycle-max 75连接池
Jedis连接池优化
@Configurationpublic class RedisConfig { @Bean public JedisPoolConfig jedisPoolConfig() { JedisPoolConfig config = new JedisPoolConfig();
// 最大连接数 config.setMaxTotal(50);
// 最大空闲连接 config.setMaxIdle(20);
// 最小空闲连接 config.setMinIdle(5);
// 获取连接时最大等待时间(毫秒) config.setMaxWaitMillis(3000);
// 连接耗尽时是否阻塞 config.setBlockWhenExhausted(true);
// 获取连接时检测可用性 config.setTestOnBorrow(false);
// 归还连接时检测可用性 config.setTestOnReturn(false);
// 空闲时检测可用性 config.setTestWhileIdle(true);
// 空闲检测时间间隔(毫秒) config.setTimeBetweenEvictionRunsMillis(30000);
return config; }
@Bean public JedisPool jedisPool(JedisPoolConfig config) { return new JedisPool( config, "localhost", 6379, 3000, // 连接超时 "password" ); }}Lettuce 连接池配置:
spring: redis: host: localhost port: 6379 password: your_password timeout: 3000 lettuce: pool: max-active: 50 # 最大连接数 max-idle: 20 # 最大空闲连接 min-idle: 5 # 最小空闲连接 max-wait: 3000 # 最大等待时间批量处理
逐行执行命令,网络开销过大
// ✅ 正确:1次网络往返redisTemplate.executePipelined(new RedisCallback<Object>() { @Override public Object doInRedis(RedisConnection connection) { for (int i = 0; i < 1000; i++) { connection.set( ("key:" + i).getBytes(), ("value:" + i).getBytes() ); } return null; }});支持与分享
如果这篇文章对你有帮助,欢迎分享给更多人或打赏支持!